반응형

전체 글 449

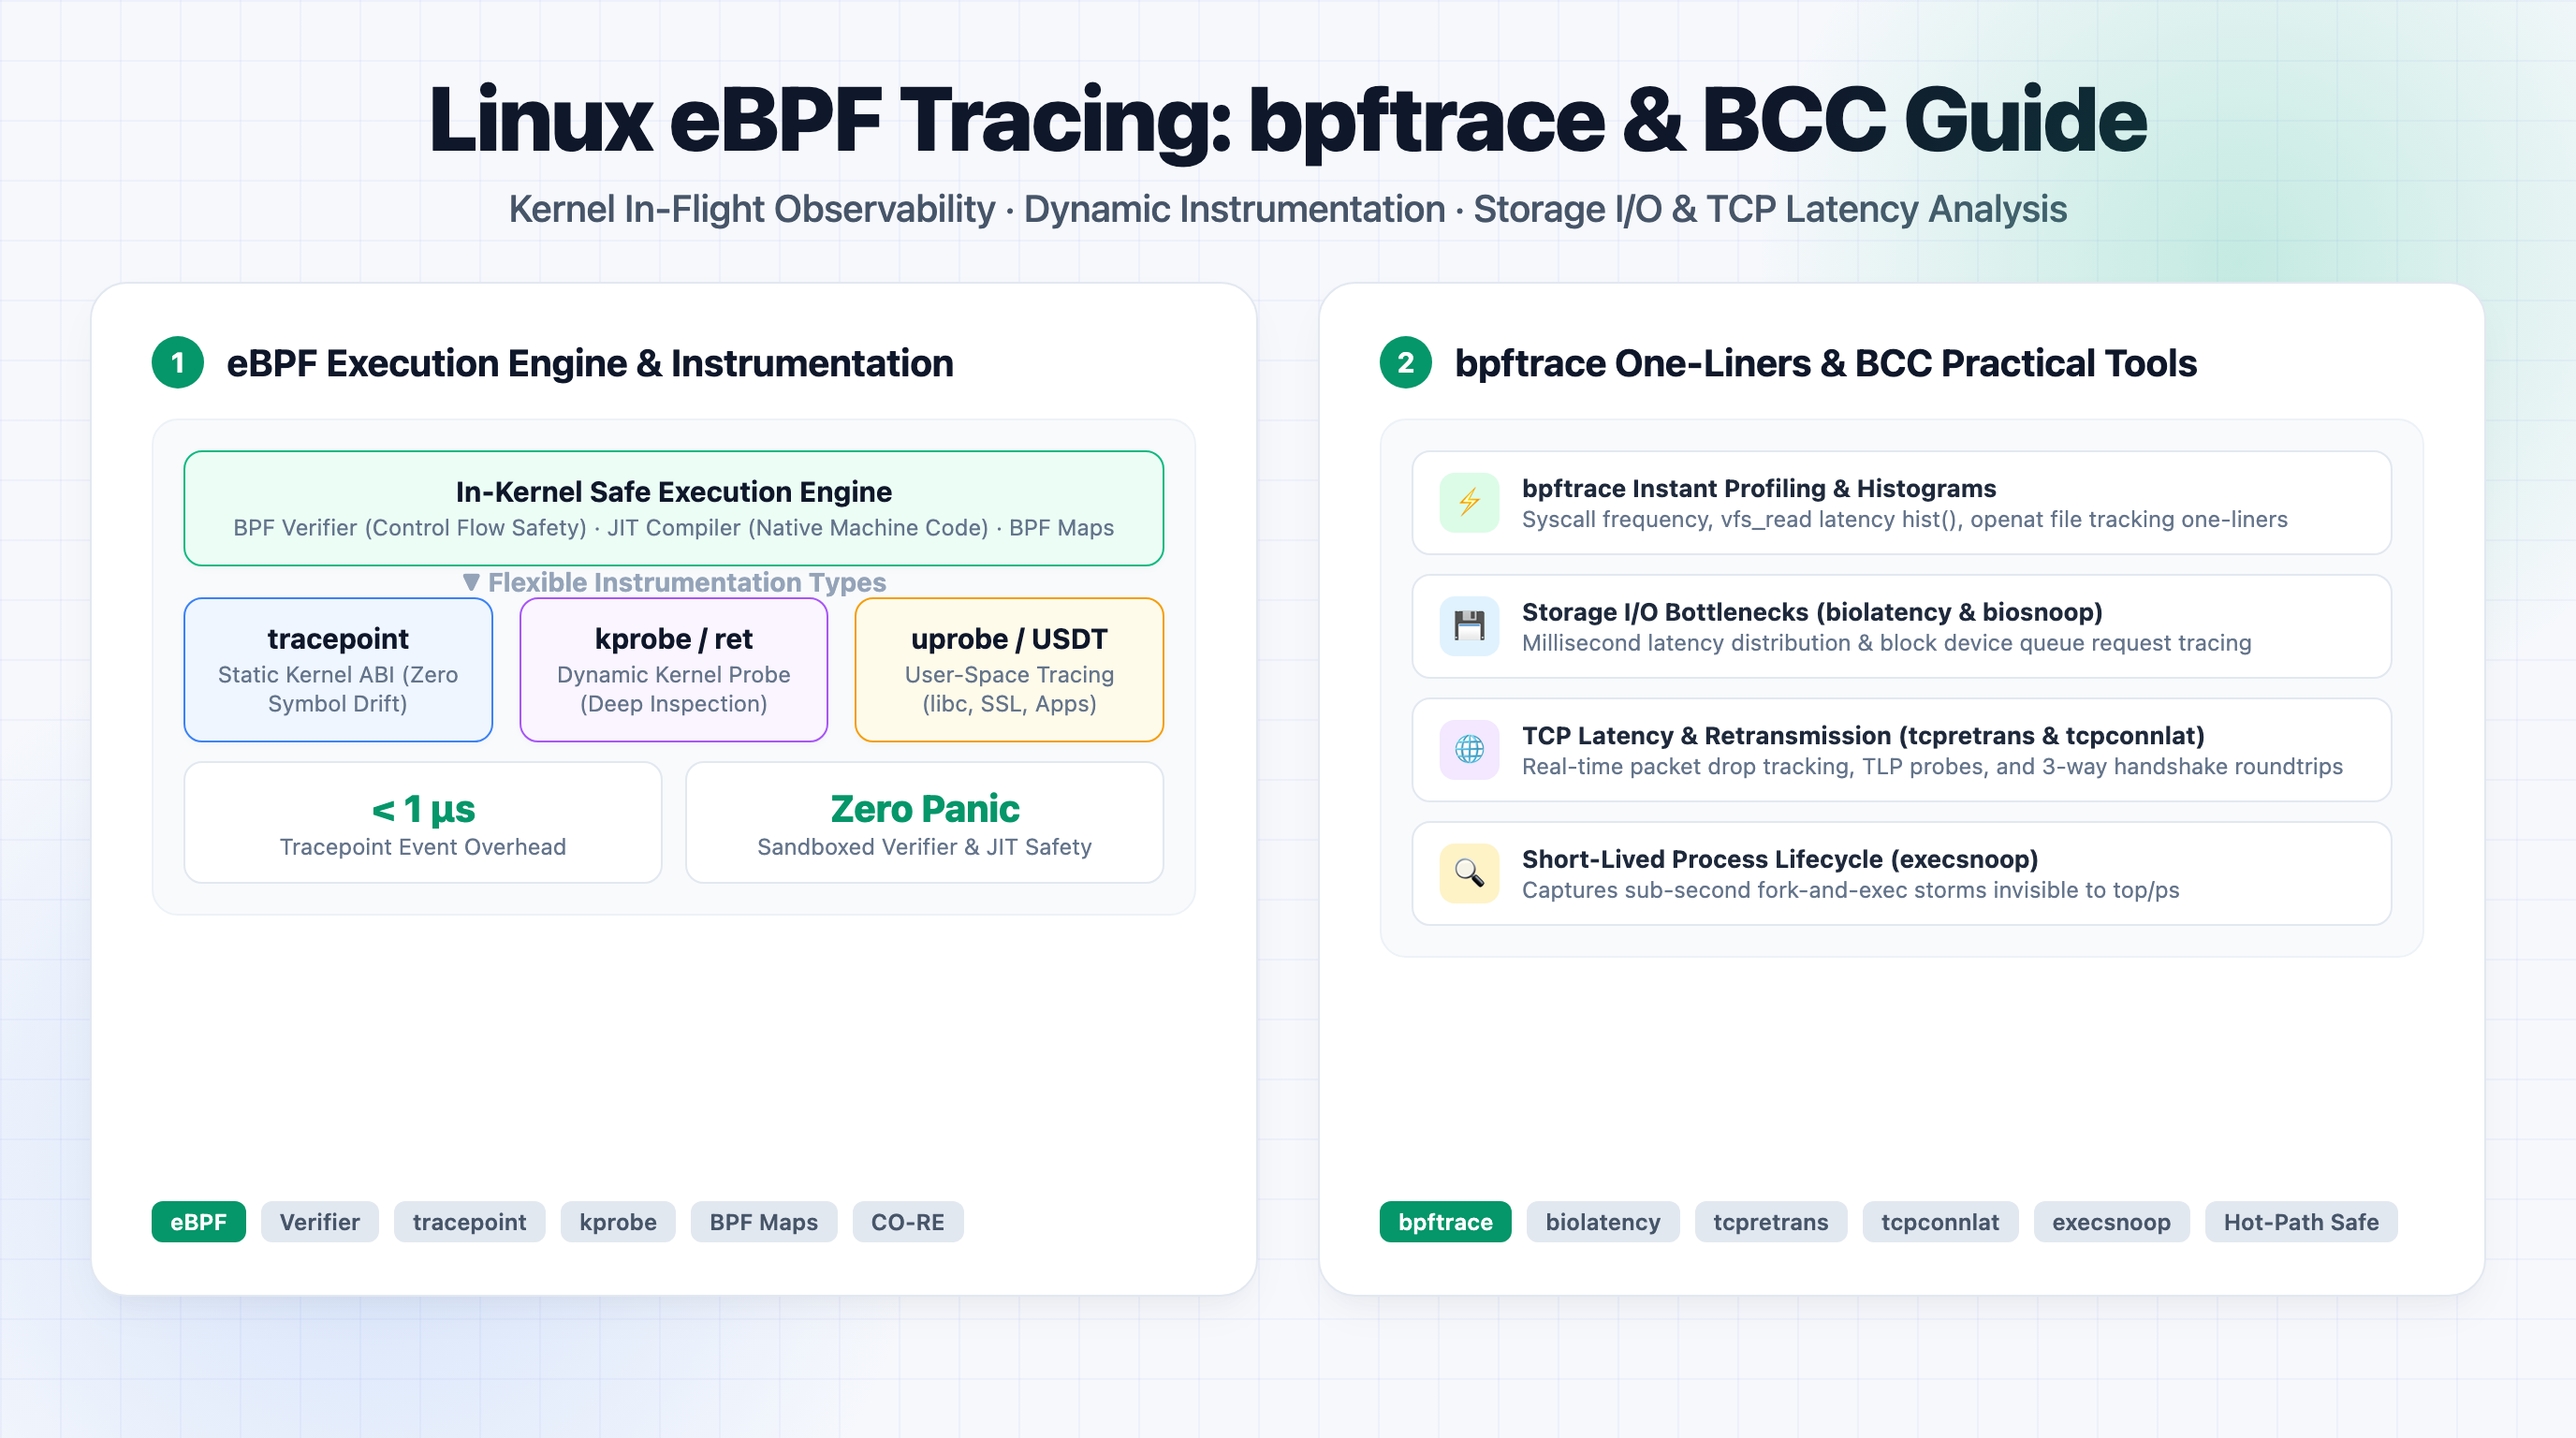
bpftrace와 bcc로 시작하는 eBPF 시스템 분석

Overview대규모 트래픽을 처리하는 프로덕션 리눅스 환경에서 알 수 없는 지연 시간 급증(Tail Latency Spike), 디스크 I/O 병목, 네트워크 패킷 유실, 일시적인 CPU 사용률 상승은 엔지니어가 마주하는 가장 까다로운 장애 유형이다. 전통적인 모니터링 도구인 `top`, `vmstat`, `iostat`, `netstat` 등은 1초 또는 수 초 단위의 평균 통계치만을 제공하기 때문에 수 밀리초 동안 순간적으로 발생했다 사라지는 이상 징후를 감지하지 못한다. 또한 애플리케이션 로그나 유저 공간 APM 도구만으로는 커널 내부의 스케줄링 지연, 파일시스템 락 경합, TCP 소켓 큐 대기 시간과 같은 심층 시스템 병목의 근본 원인을 추적하기 어렵다. eBPF(Extended Berkeley..
Linux 00:00:15

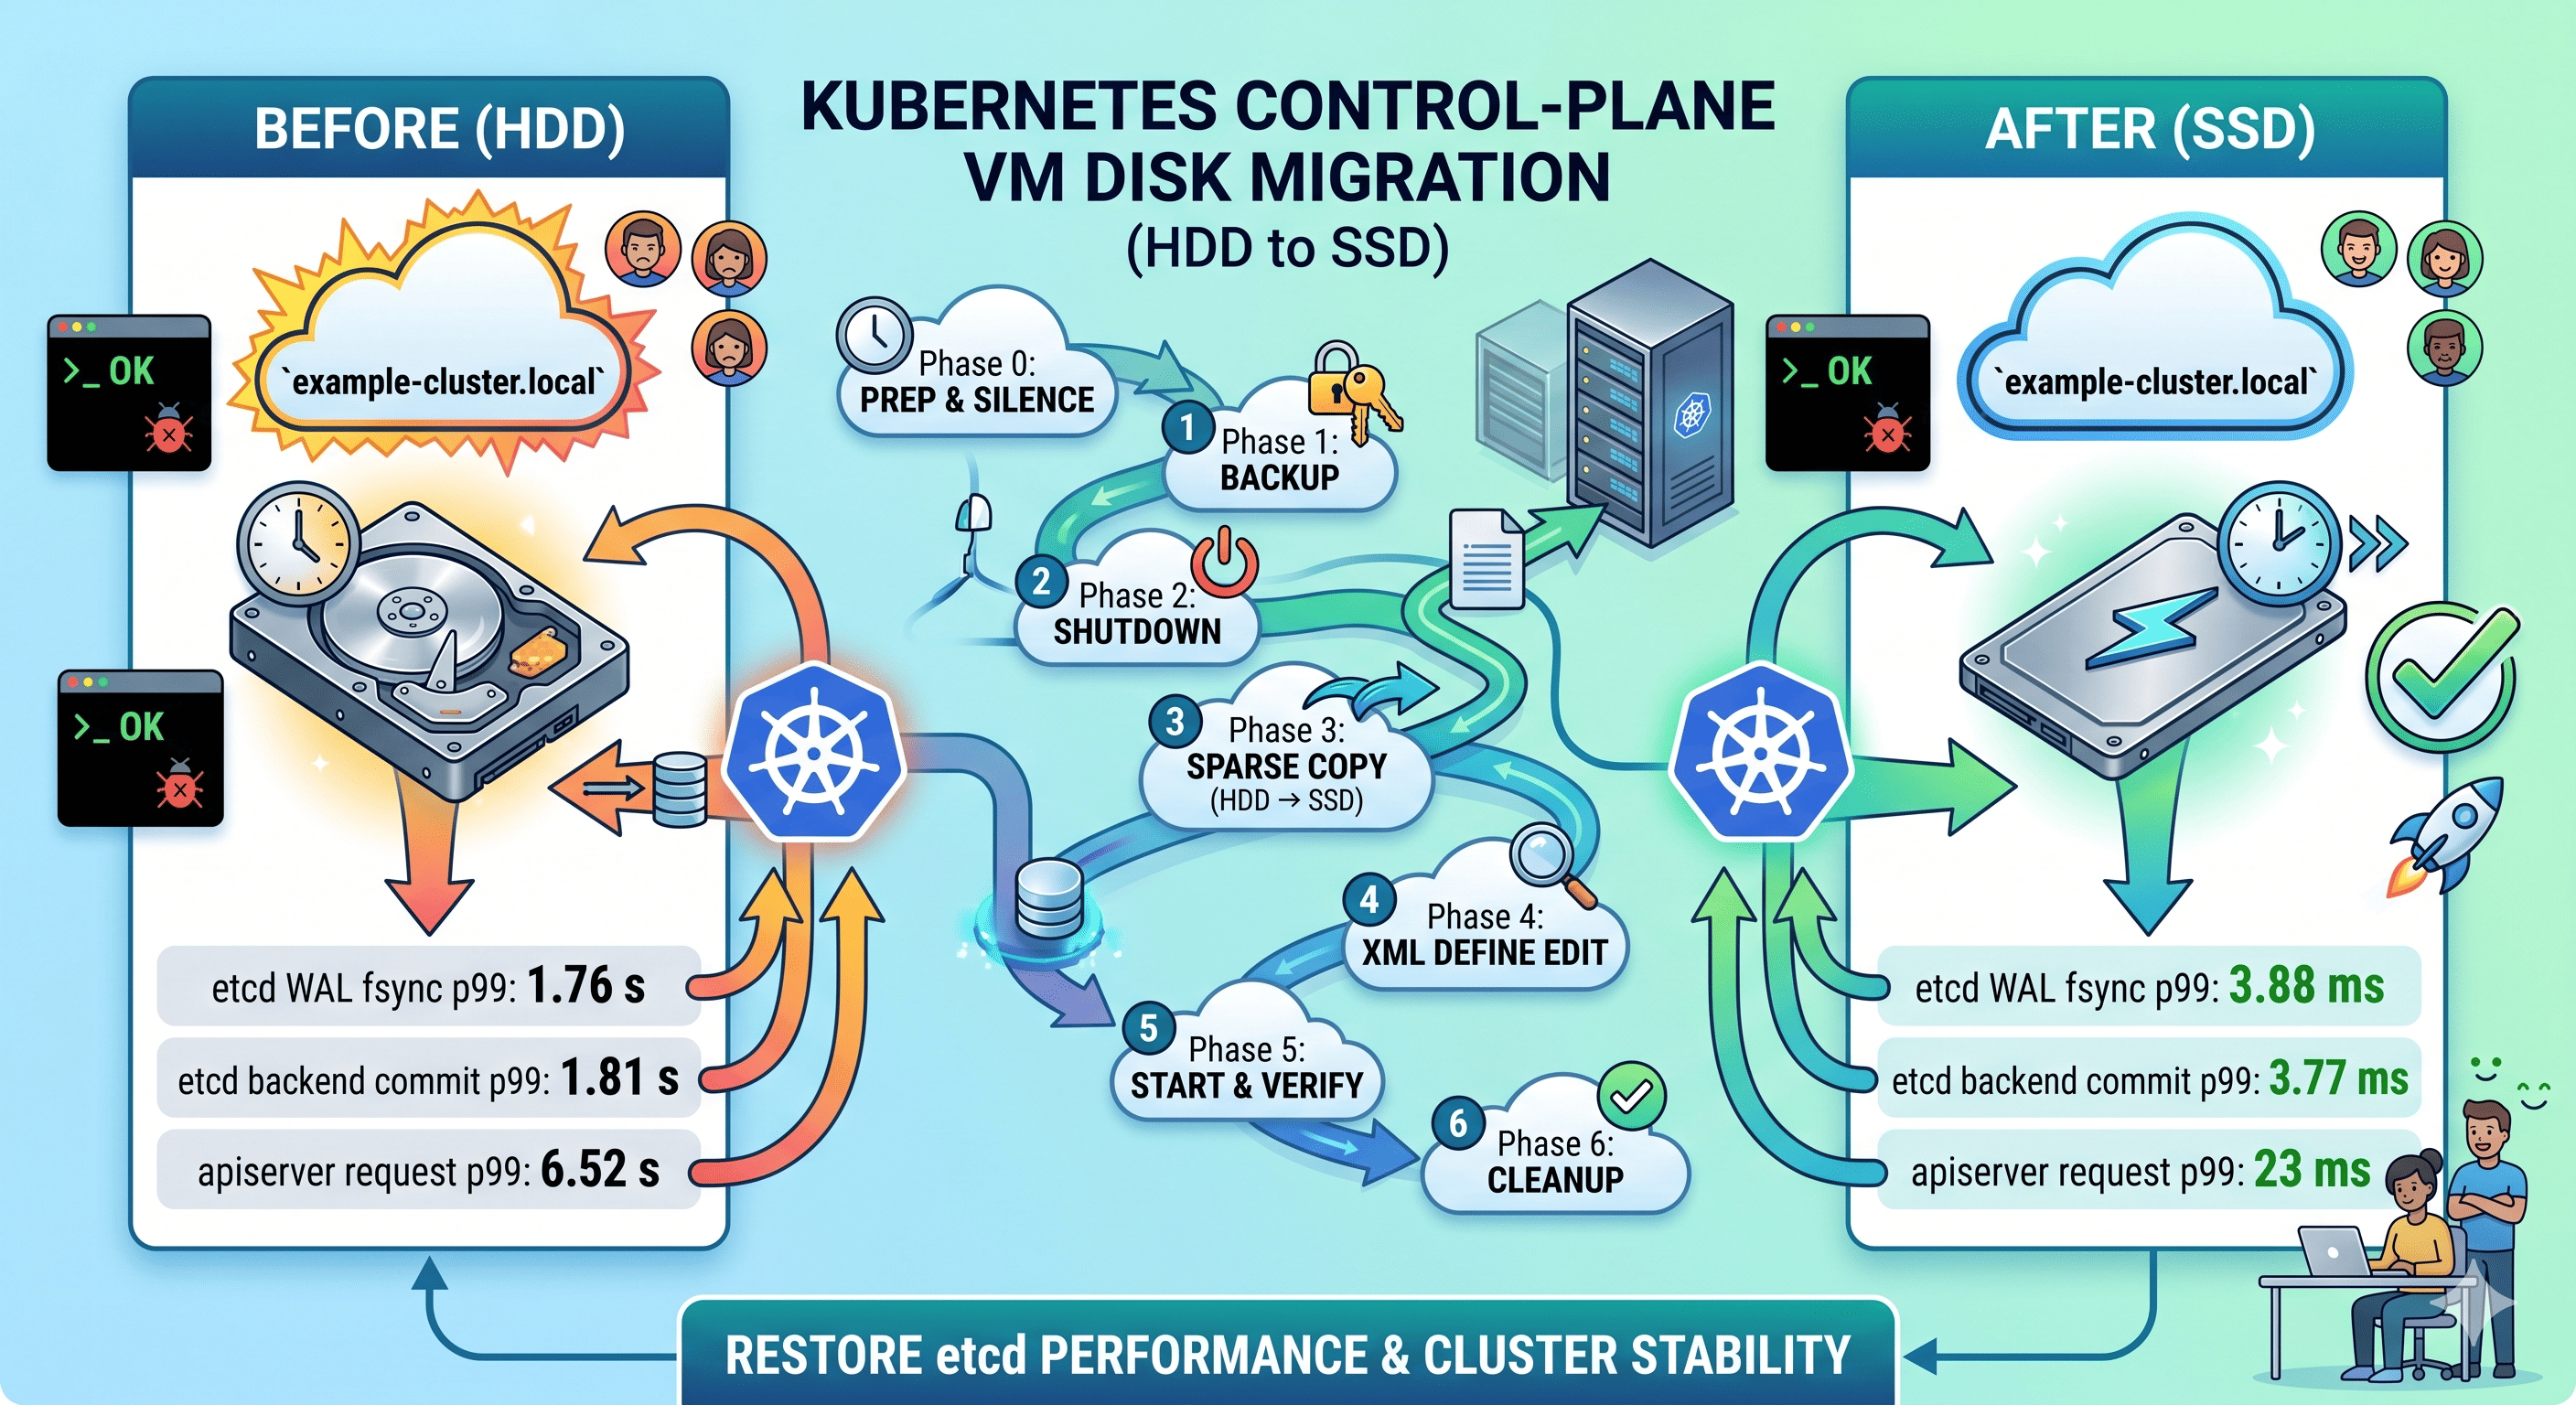
Kubernetes etcd 디스크 이전기 (HDD → SSD) - 단일 control-plane VM 마이그레이션

Overview운영 중이던 Kubernetes 클러스터(`example-cluster.local`)에서 두 차례의 etcd / apiserver 지연 사고가 발생했다. 원인을 추적해 보니 control-plane VM 의 disk 가 hypervisor host 의 HDD 위에 올라가 있다는 것이 문제였다. etcd 는 모든 write 마다 WAL fsync 를 하기 때문에 회전 디스크의 seek latency 가 그대로 클러스터 전체 지연으로 이어진다. 이 글에서는 `kubespray` 로 구성한 external etcd 환경에서 single control-plane VM 의 qcow2 disk 를 HDD 에서 SSD 로 이전한 절차와, 그 결과 etcd WAL fsync p99 가 1.76초 → 3...

Migration 2026.11.19

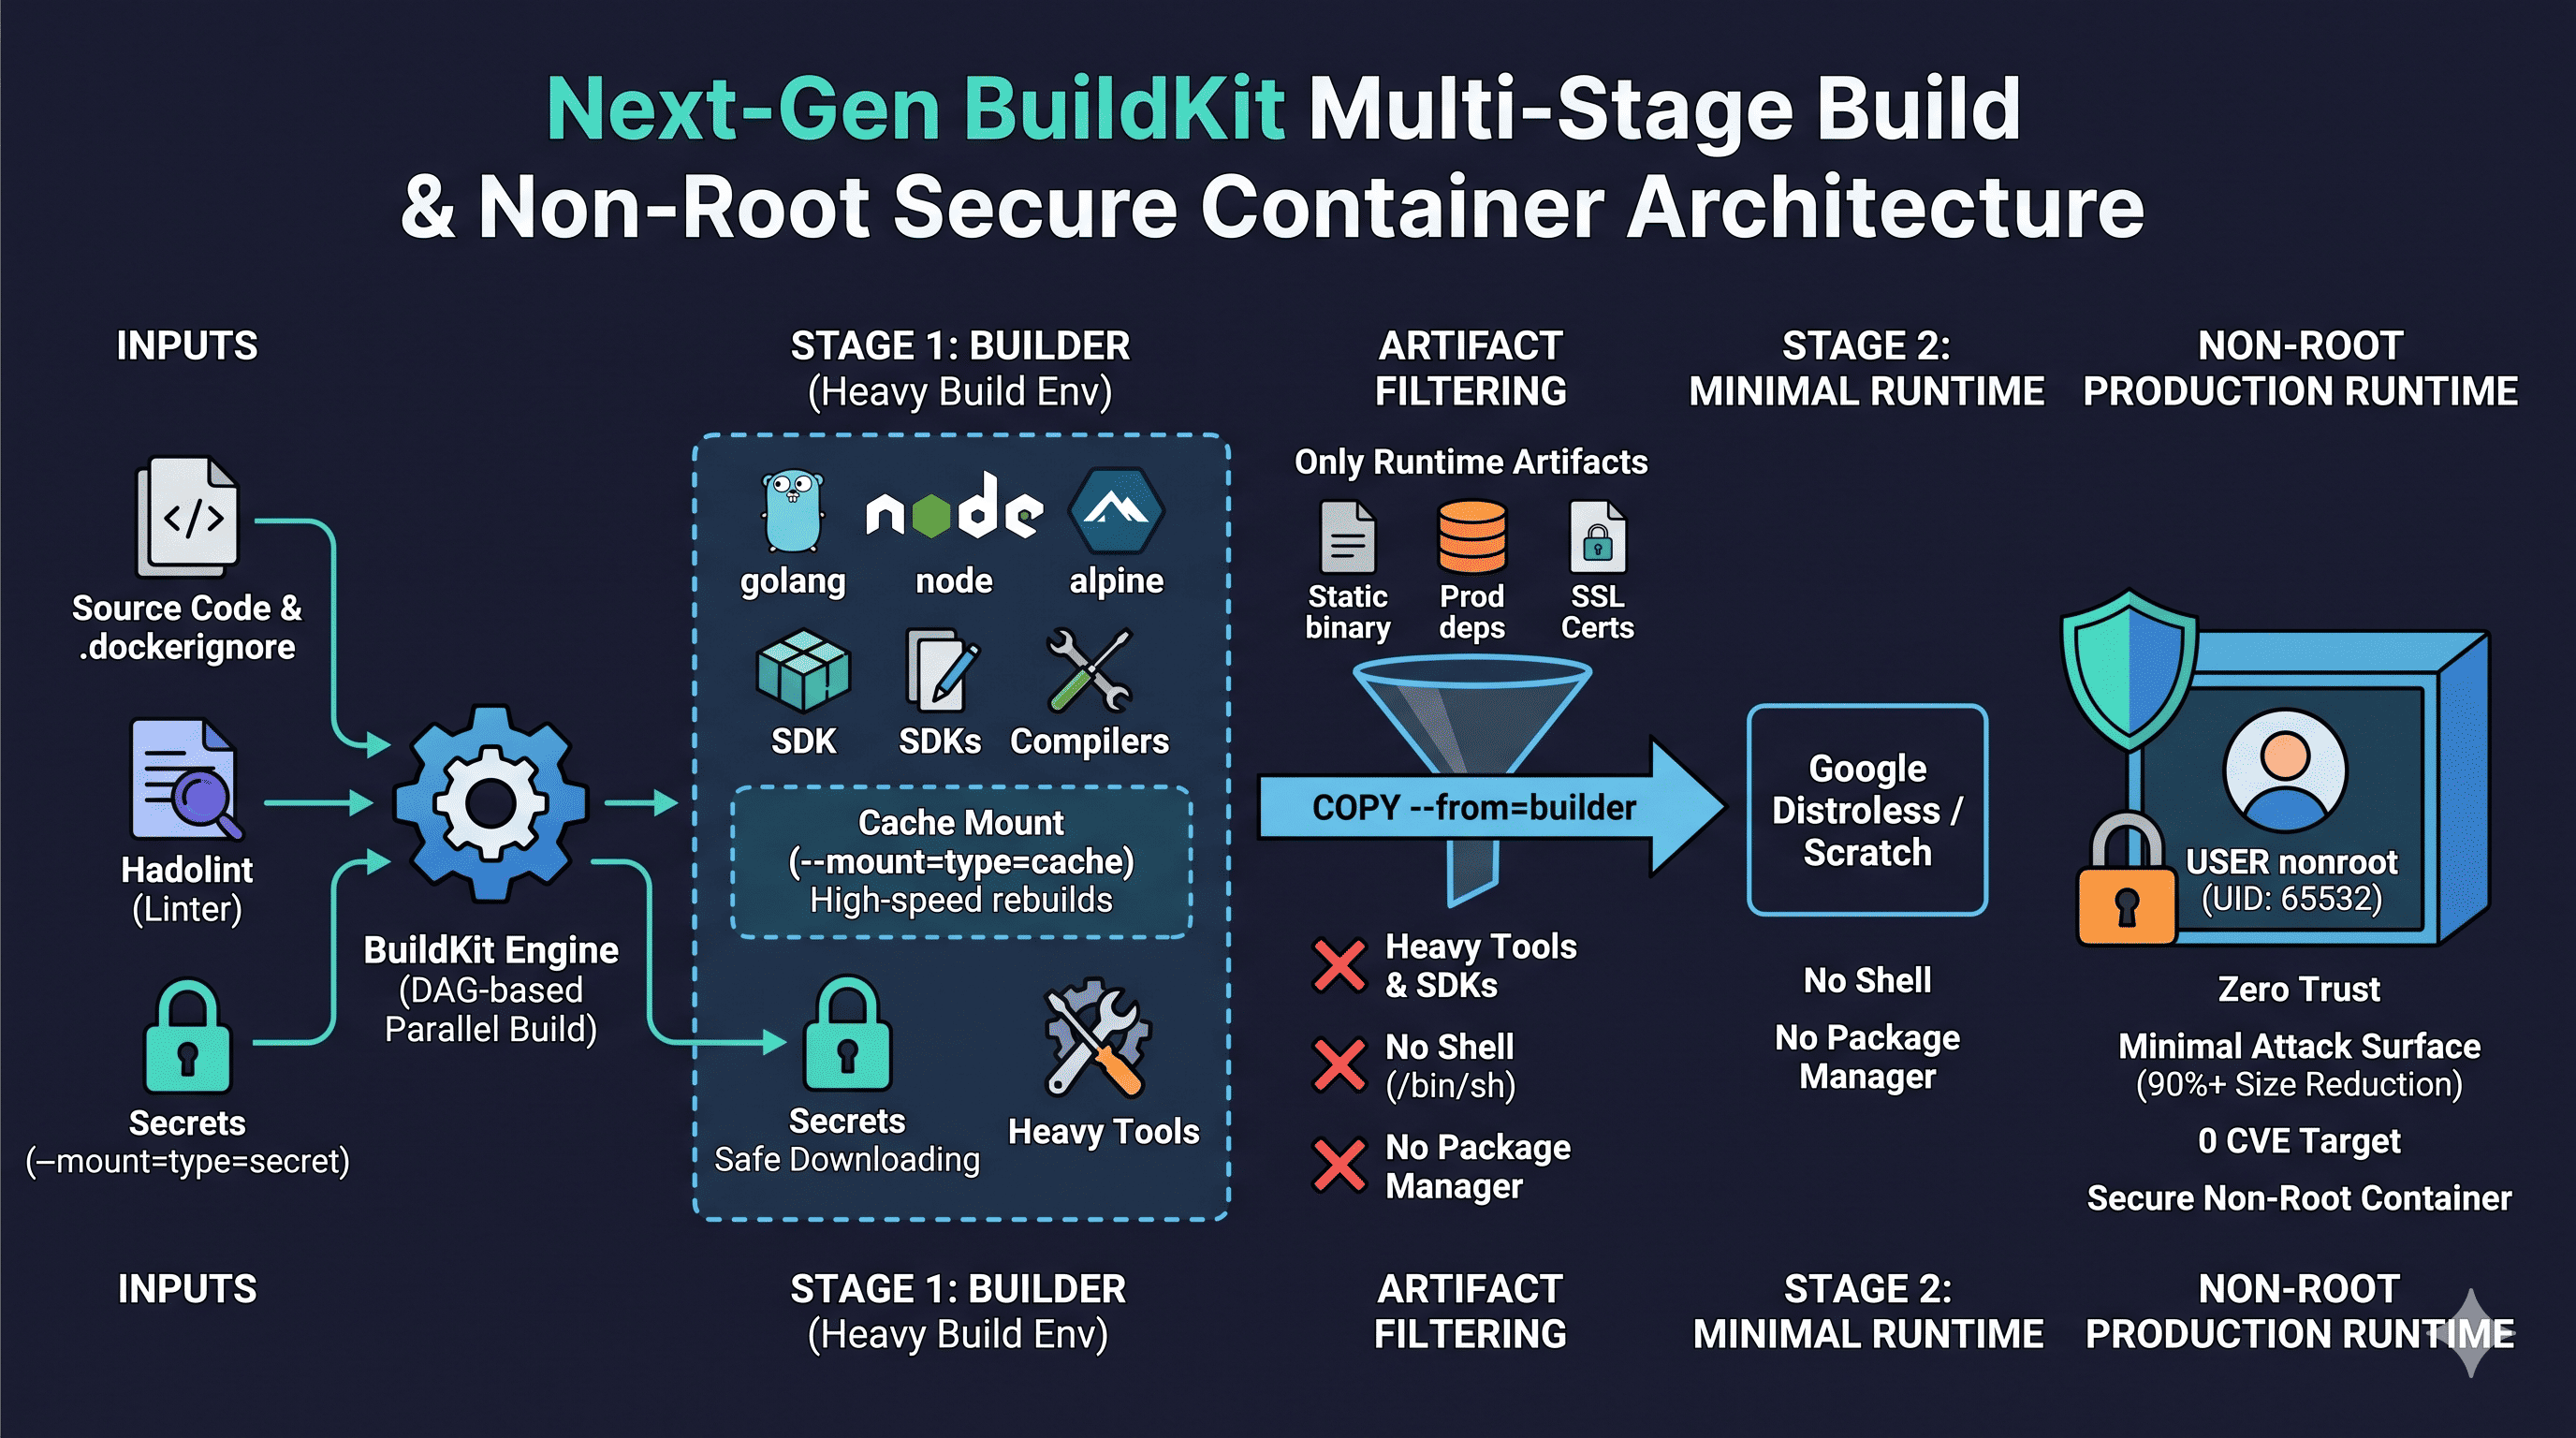
BuildKit 캐시와 멀티 스테이지로 Dockerfile 최적화

Overview클라우드 네이티브 및 마이크로서비스 아키텍처가 성숙함에 따라 Dockerfile은 단순한 애플리케이션 실행 스크립트에 머무르지 않는다. 오늘날 컨테이너 이미지는 CI/CD 파이프라인의 빌드 속도, 네트워크 전송 대역폭 비용, 그리고 프로덕션 런타임의 제로 트러스트 보안을 결정짓는 핵심 인프라 소프트웨어 아티팩트로 취급된다. 그러나 실제 현업의 많은 프로젝트에서는 여전히 빌드 환경과 런타임이 결합된 거대한 단일 이미지, 비효율적인 레이어 구조로 인한 캐시 미스, 패키지 관리자의 임시 파일 누적, 그리고 루트(root) 권한 실행 등 레거시 패턴이 광범위하게 답습되고 있다. 이러한 문제들을 근본적으로 해결하기 위해 차세대 컨테이너 빌드 엔진인 BuildKit과 멀티 스테이지 빌드, 그리고 최소..

IaC/Container 2026.11.19

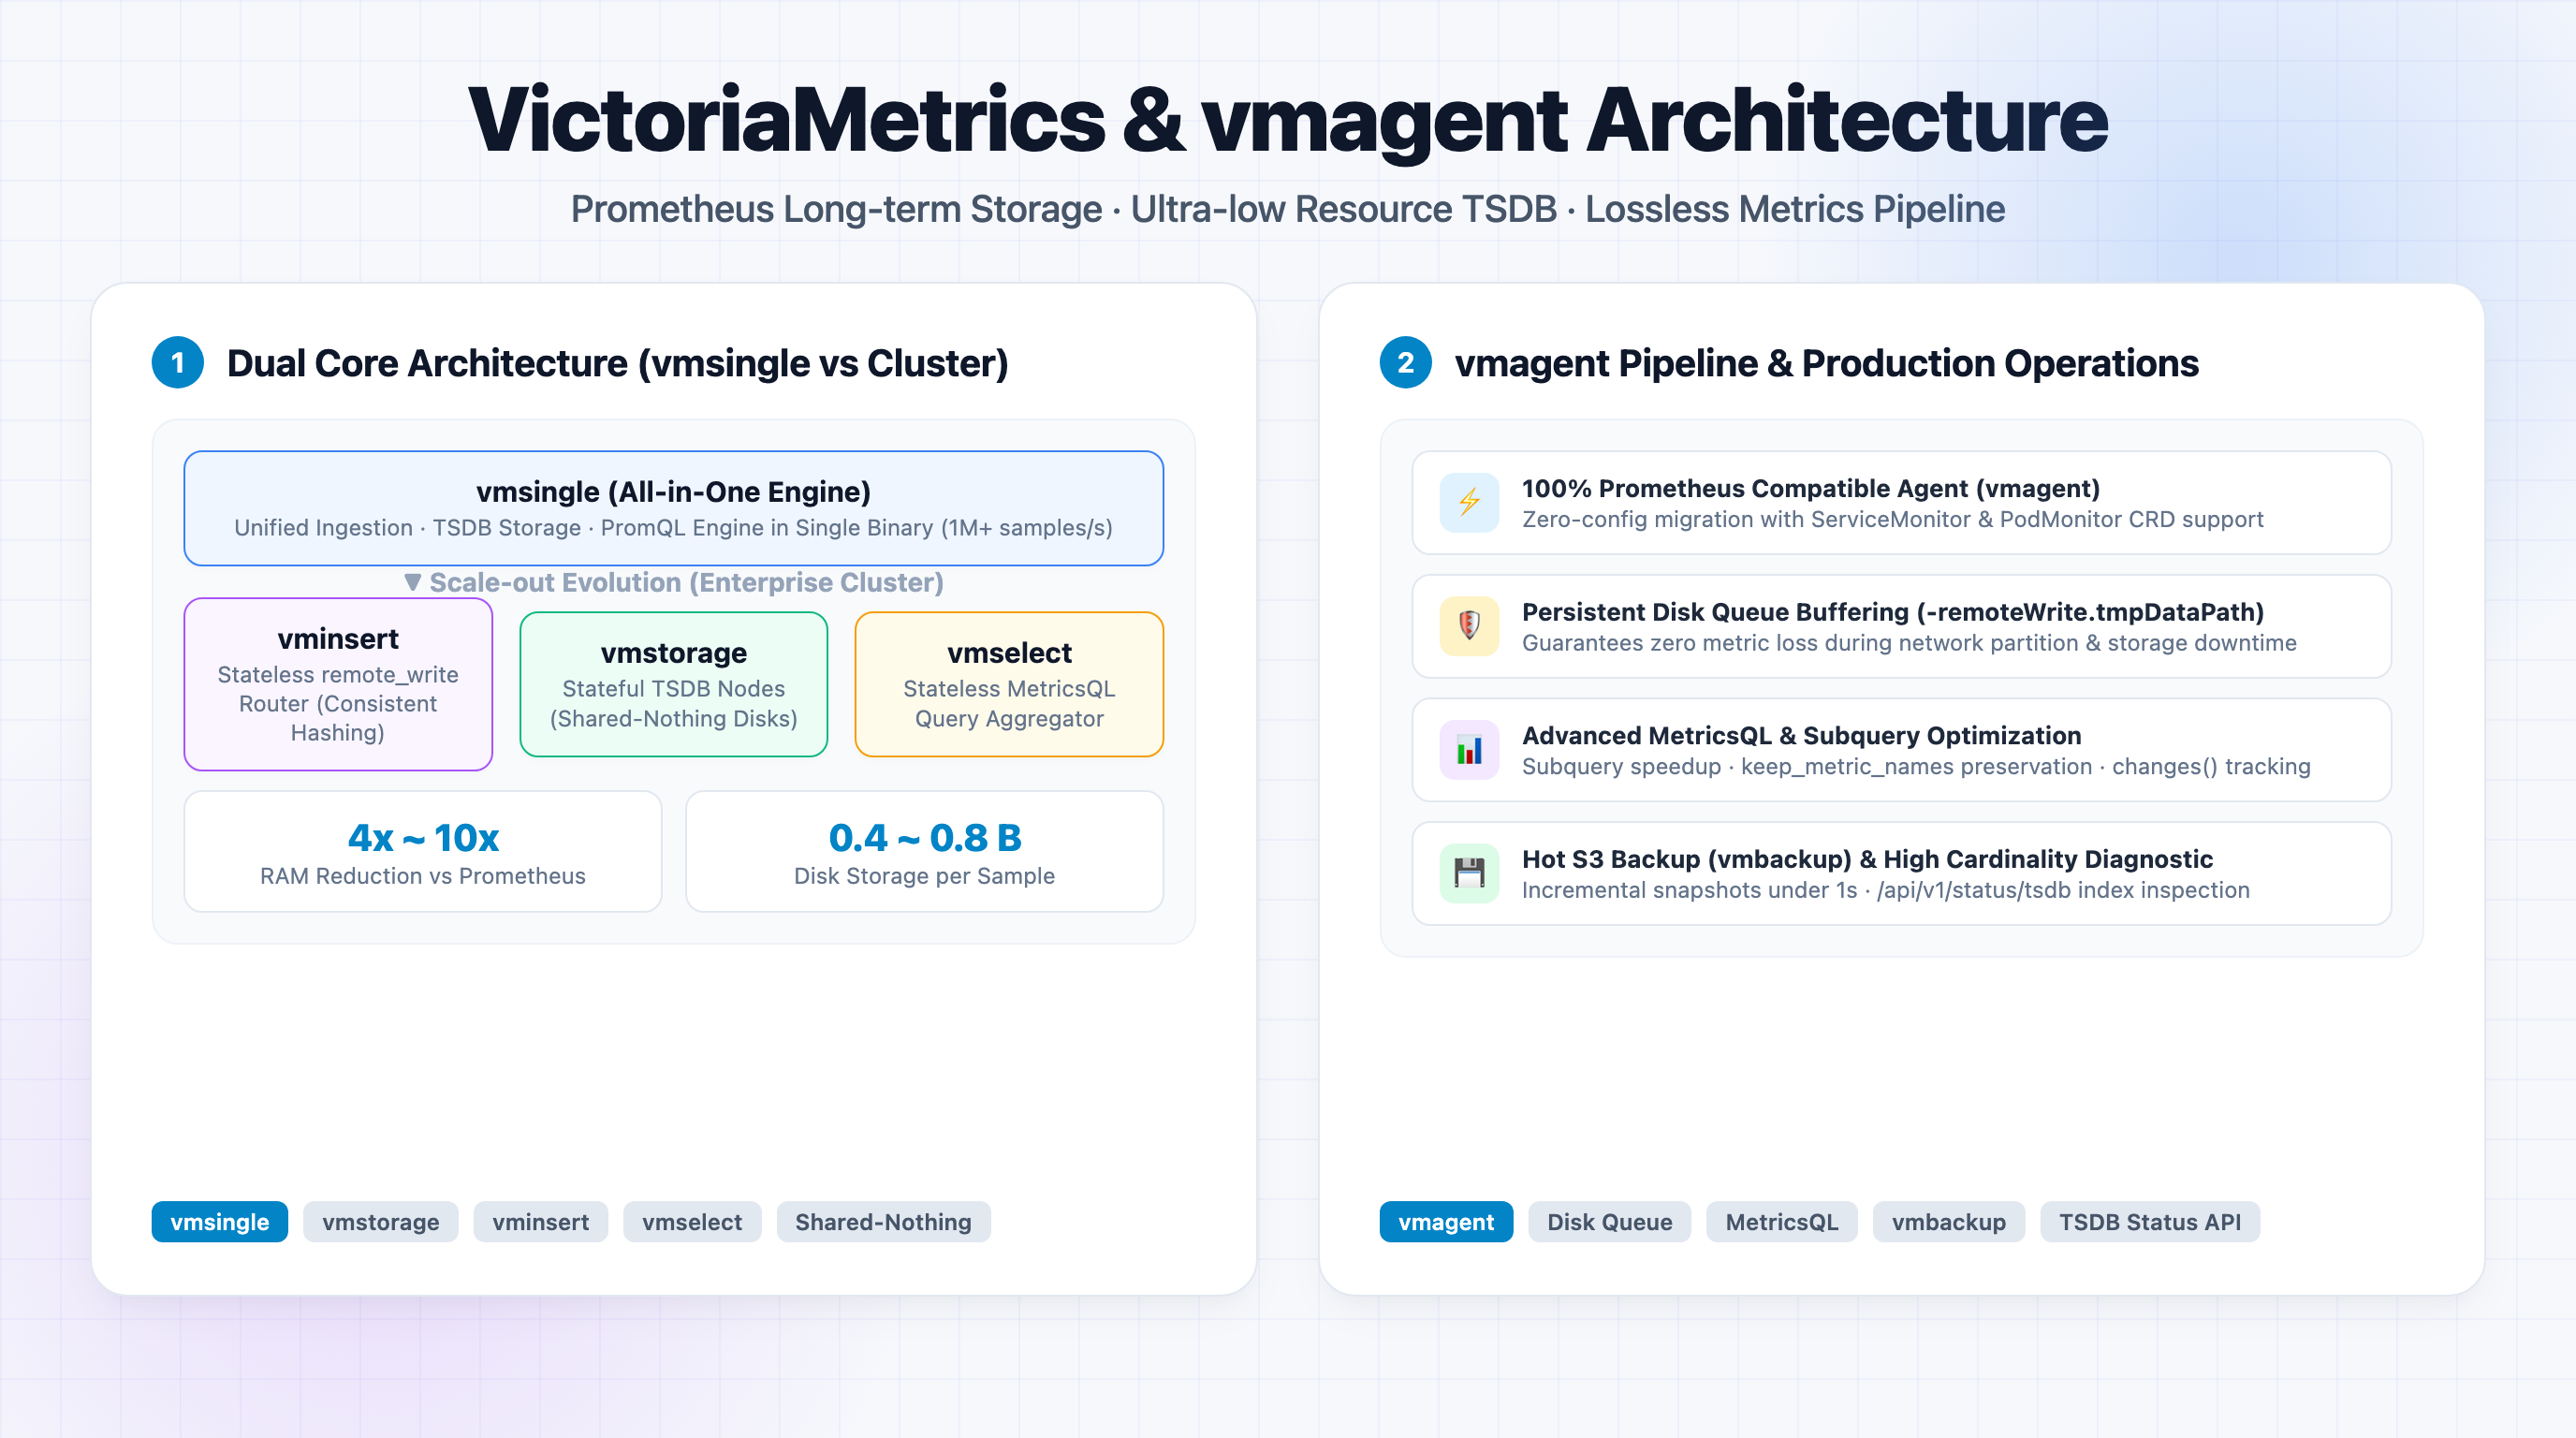
VictoriaMetrics로 Prometheus 메트릭 장기 보관하기

OverviewKubernetes 클러스터 환경이 대규모로 확장됨에 따라 수집되는 시계열 메트릭 데이터의 양은 기하급수적으로 증가한다. 수백 대의 노드와 수만 개의 파드에서 쏟아지는 메트릭을 단일 Prometheus 인스턴스로 수집·보관할 경우, 높은 메모리 점유율로 인한 OOM-Kill 발생, 장기 보관에 따른 로컬 디스크 I/O 병목, 쿼리 응답 속도 저하 문제가 상시적인 운영 리스크로 부상한다. 이러한 한계를 극복하기 위해 오브젝트 스토리지 기반 장기 보관 솔루션으로 Thanos를 도입하기도 하지만, Sidecar, Store Gateway, Querier, Compactor 등 관리해야 하는 컴포넌트가 많아 인프라 운영 복잡도가 가중되는 트레이드오프가 존재한다. VictoriaMetrics는 이러..

Observability 2026.11.18

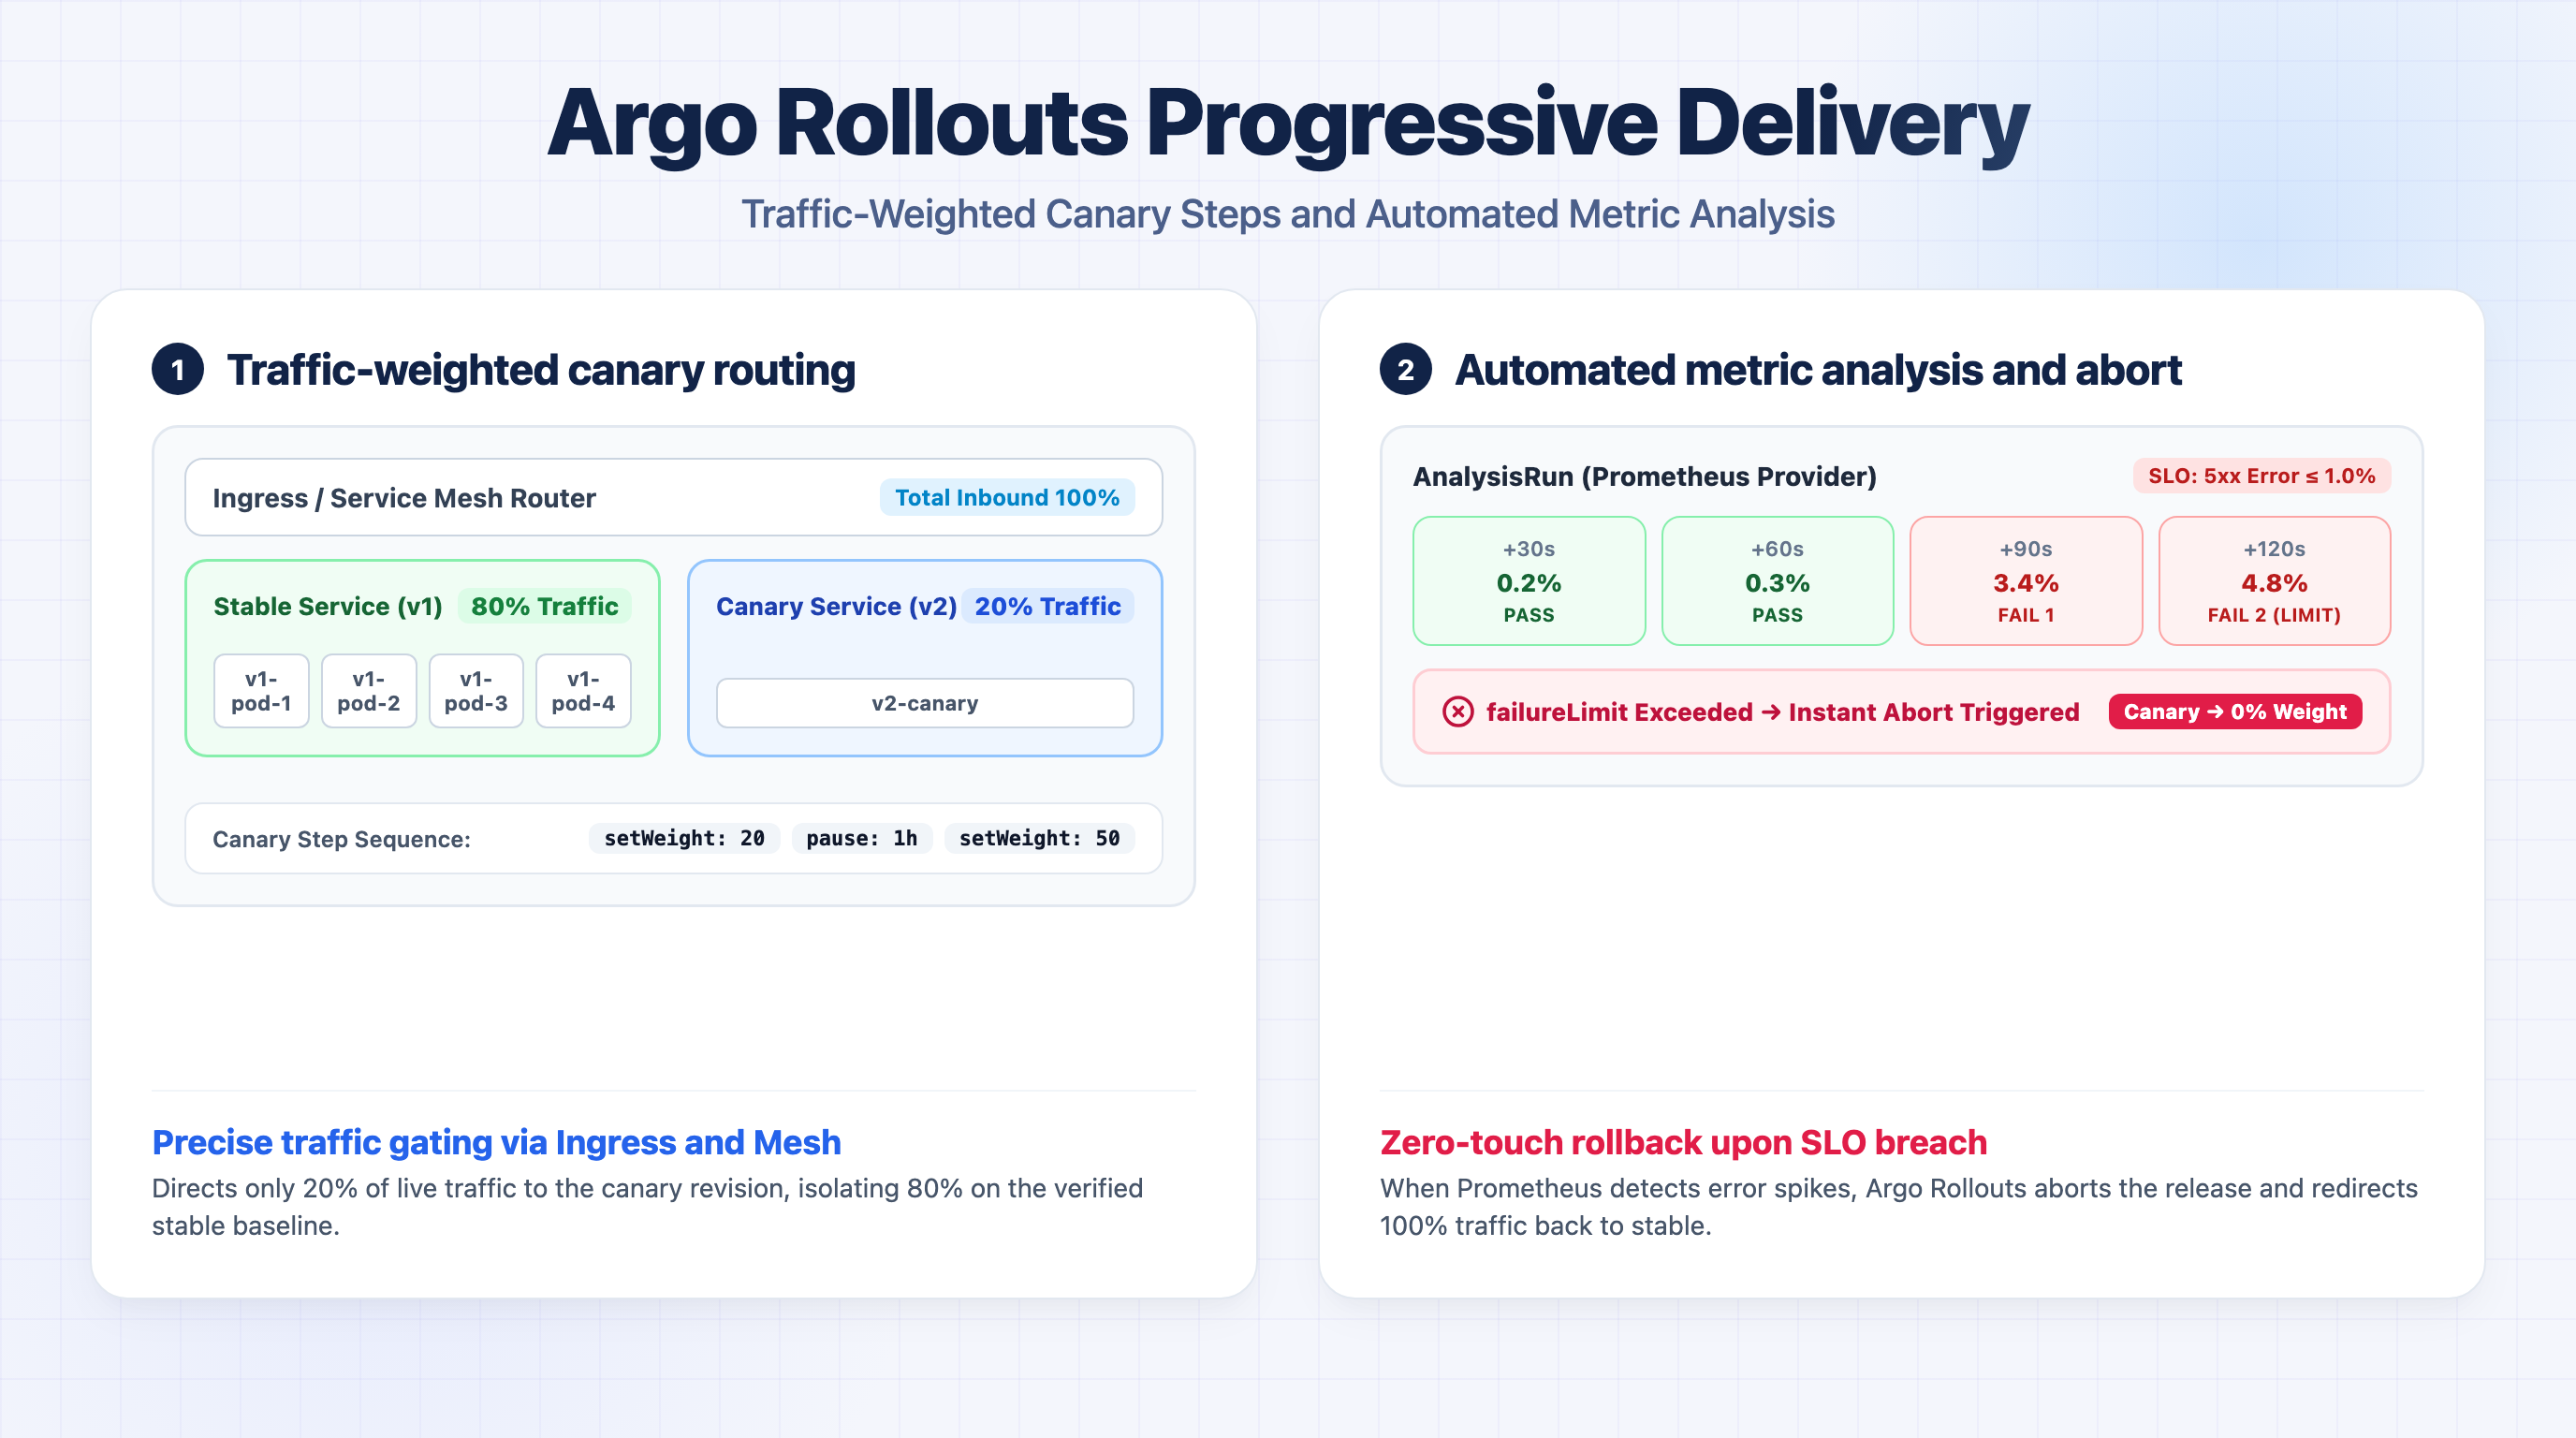
Argo Rollouts 카나리와 메트릭 기반 자동 롤백

Overview쿠버네티스 기본 워크로드 리소스인 Deployment의 롤링 업데이트(RollingUpdate)는 파드의 기동과 준비 상태(Readiness probe)만을 기준으로 배포를 진행한다. 이로 인해 런타임에 실제 트래픽이 유입되면서 발생하는 비즈니스 로직 결함, 데이터베이스 커넥션 고갈, 비정상적인 HTTP 5xx 에러 폭증을 감지하지 못하고 이전 파드를 순차적으로 모두 교체하여 전체 서비스 장애로 확산되는 구조적 한계를 안고 있다. 이러한 문제를 해결하기 위해 등장한 개념이 점진적 배포(Progressive Delivery)이며, 쿠버네티스 생태계에서 이를 가장 체계적으로 지원하는 도구가 Argo Rollouts다. Argo Rollouts는 신규 버전에 트래픽의 일부(예: 5%, 20%)만..

IaC/CI CD Tool 2026.11.17

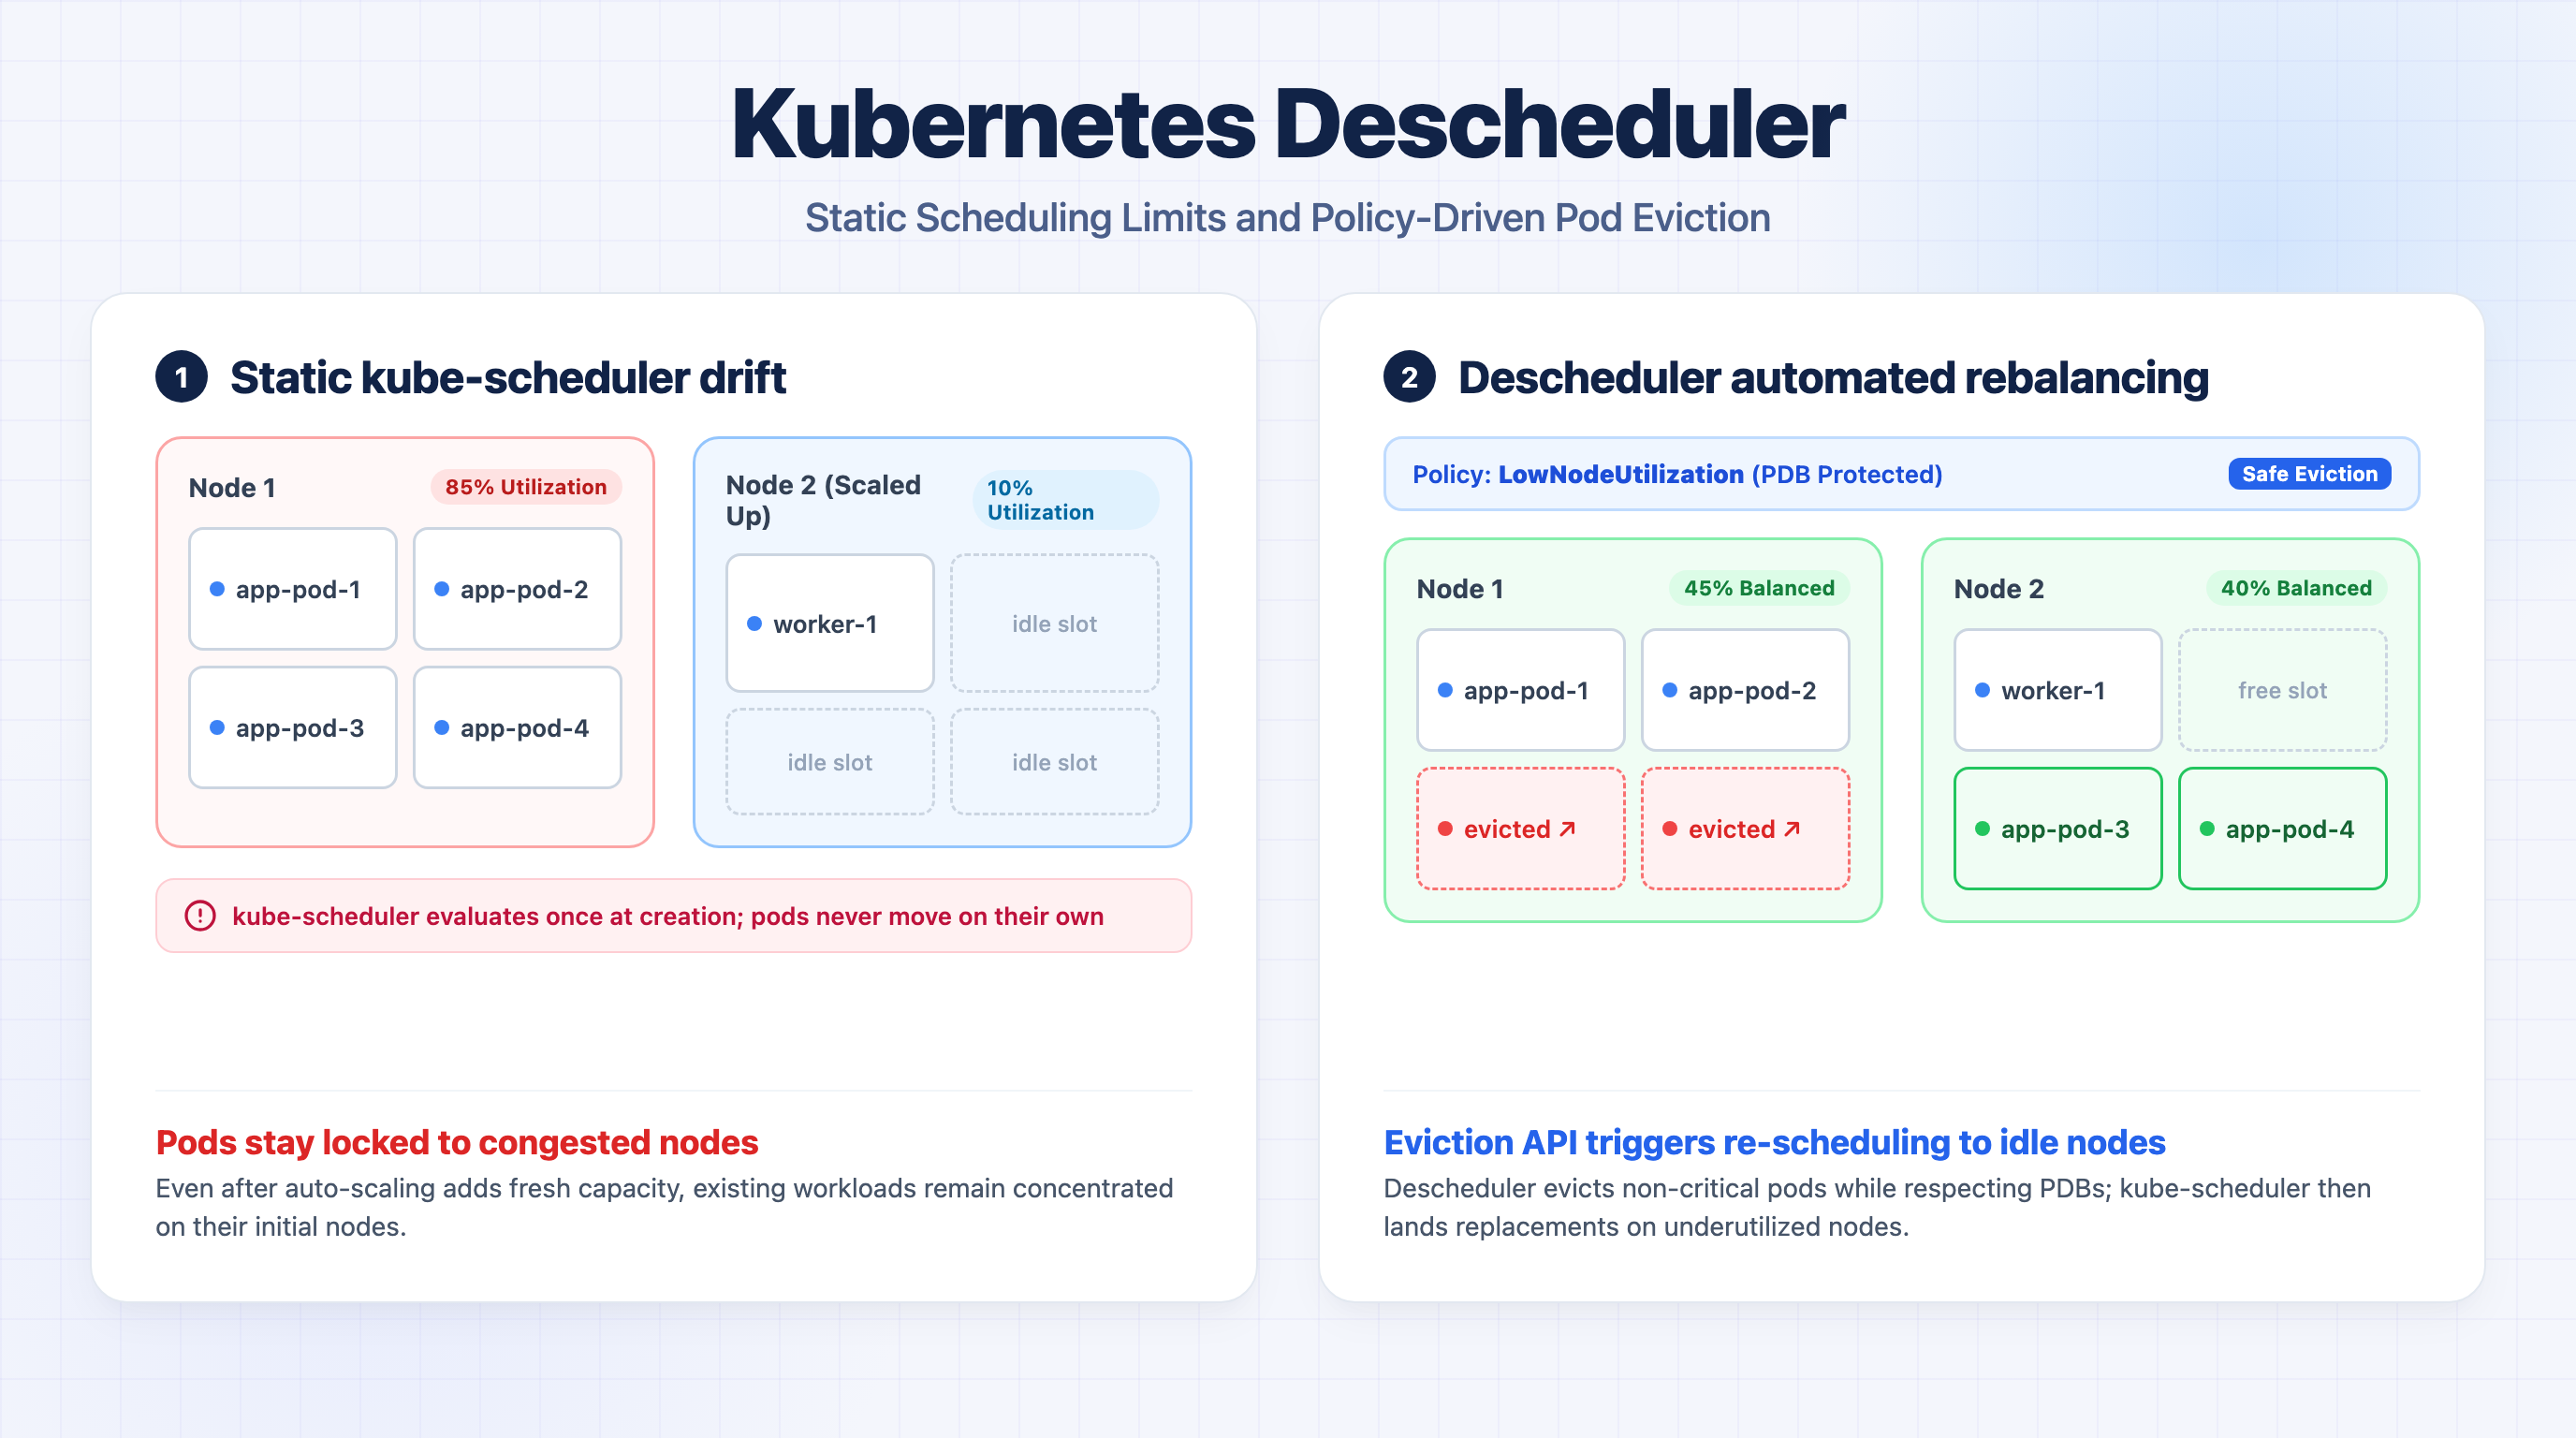
Descheduler로 노드 간 파드 불균형 해소하기

Overview쿠버네티스의 기본 스케줄러인 `kube-scheduler`는 파드가 생성되어 대기열에 들어온 시점의 클러스터 상태만을 기준으로 배포 대상 노드를 결정한다. 하지만 노드 장애 후 복구, 스팟 인스턴스 중단, 워크로드 스케일링, 노드 테인트 및 라벨 변경 등이 반복되면 초기에 최적이었던 파드 배치가 급격하게 무너진다. 파드는 한 번 노드에 바인딩되면 스스로 다른 노드로 이동하지 않으므로, 특정 노드에만 파드가 집중되거나 신규 증설된 유휴 노드가 방치되는 구조적 리소스 불균형(Resource Skew)이 발생한다. kube-descheduler는 이러한 정적 스케줄링의 한계를 해결하기 위해 선언된 정책에 맞춰 부적합한 위치에 있는 파드를 감지하고 안전하게 퇴거(Eviction)시키는 쿠버네티스 ..

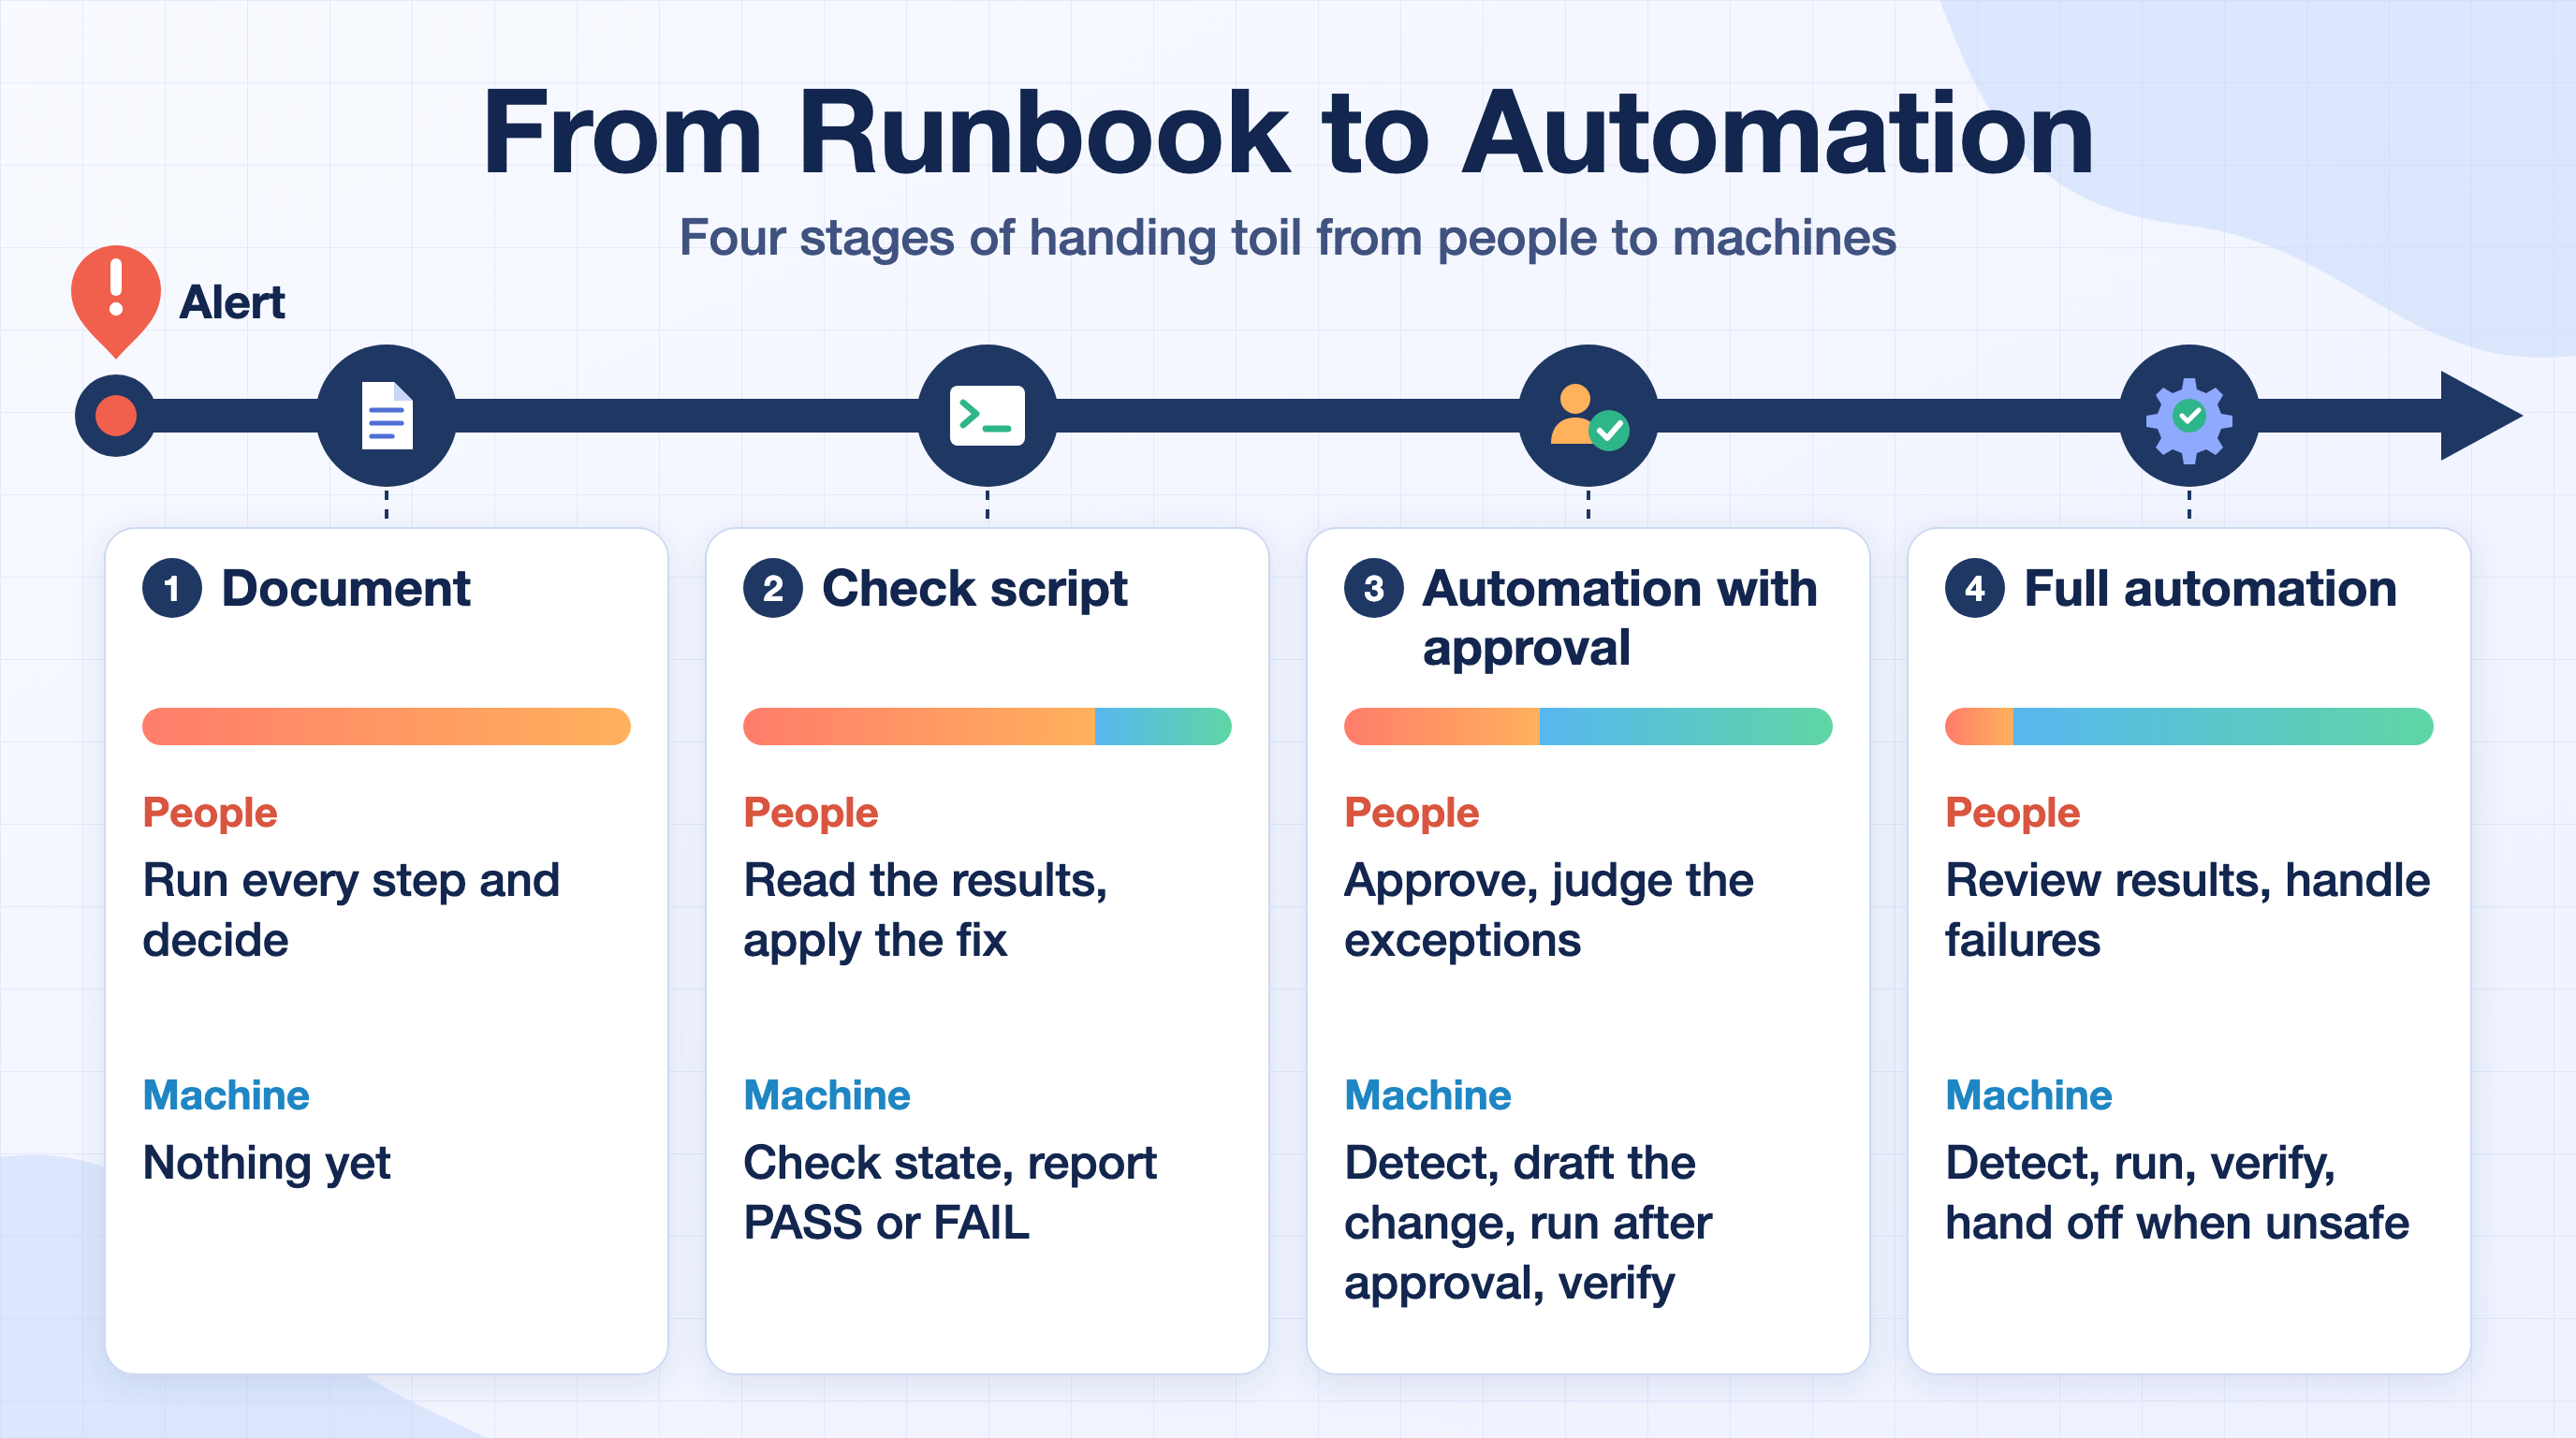
Chaos Mesh로 장애 가설 검증하기

Overview단일 장애점과 영향 범위 글에서 서버를 여러 대 두어도 같은 의존성을 공유하면 함께 멈춘다고 정리했다. 그 판단은 구성도를 읽고 내린 것이다. 정말 함께 멈추는지, 대체 응답(Fallback)을 넣으면 정말 버티는지는 장애를 넣어 봐야 안다. 이 글은 그런 주장을 가설로 바꾸고 Chaos Mesh의 PodChaos와 NetworkChaos로 시험한 기록이다. 설치 절차는 결과에 영향을 준 값만 다루고, 가설별 측정 결과를 중심으로 정리한다. 가장 먼저 볼 것은 Chaos Mesh가 주입에 성공했다고 보고했는데 실제 트래픽에는 아무 영향이 없던 경우다. 이어서 pod-kill과 프로세스 크래시의 차이, readiness 설계가 부분 장애를 전면 장애로 키우는 조건, 지연이 장애로 바뀌는 지점..

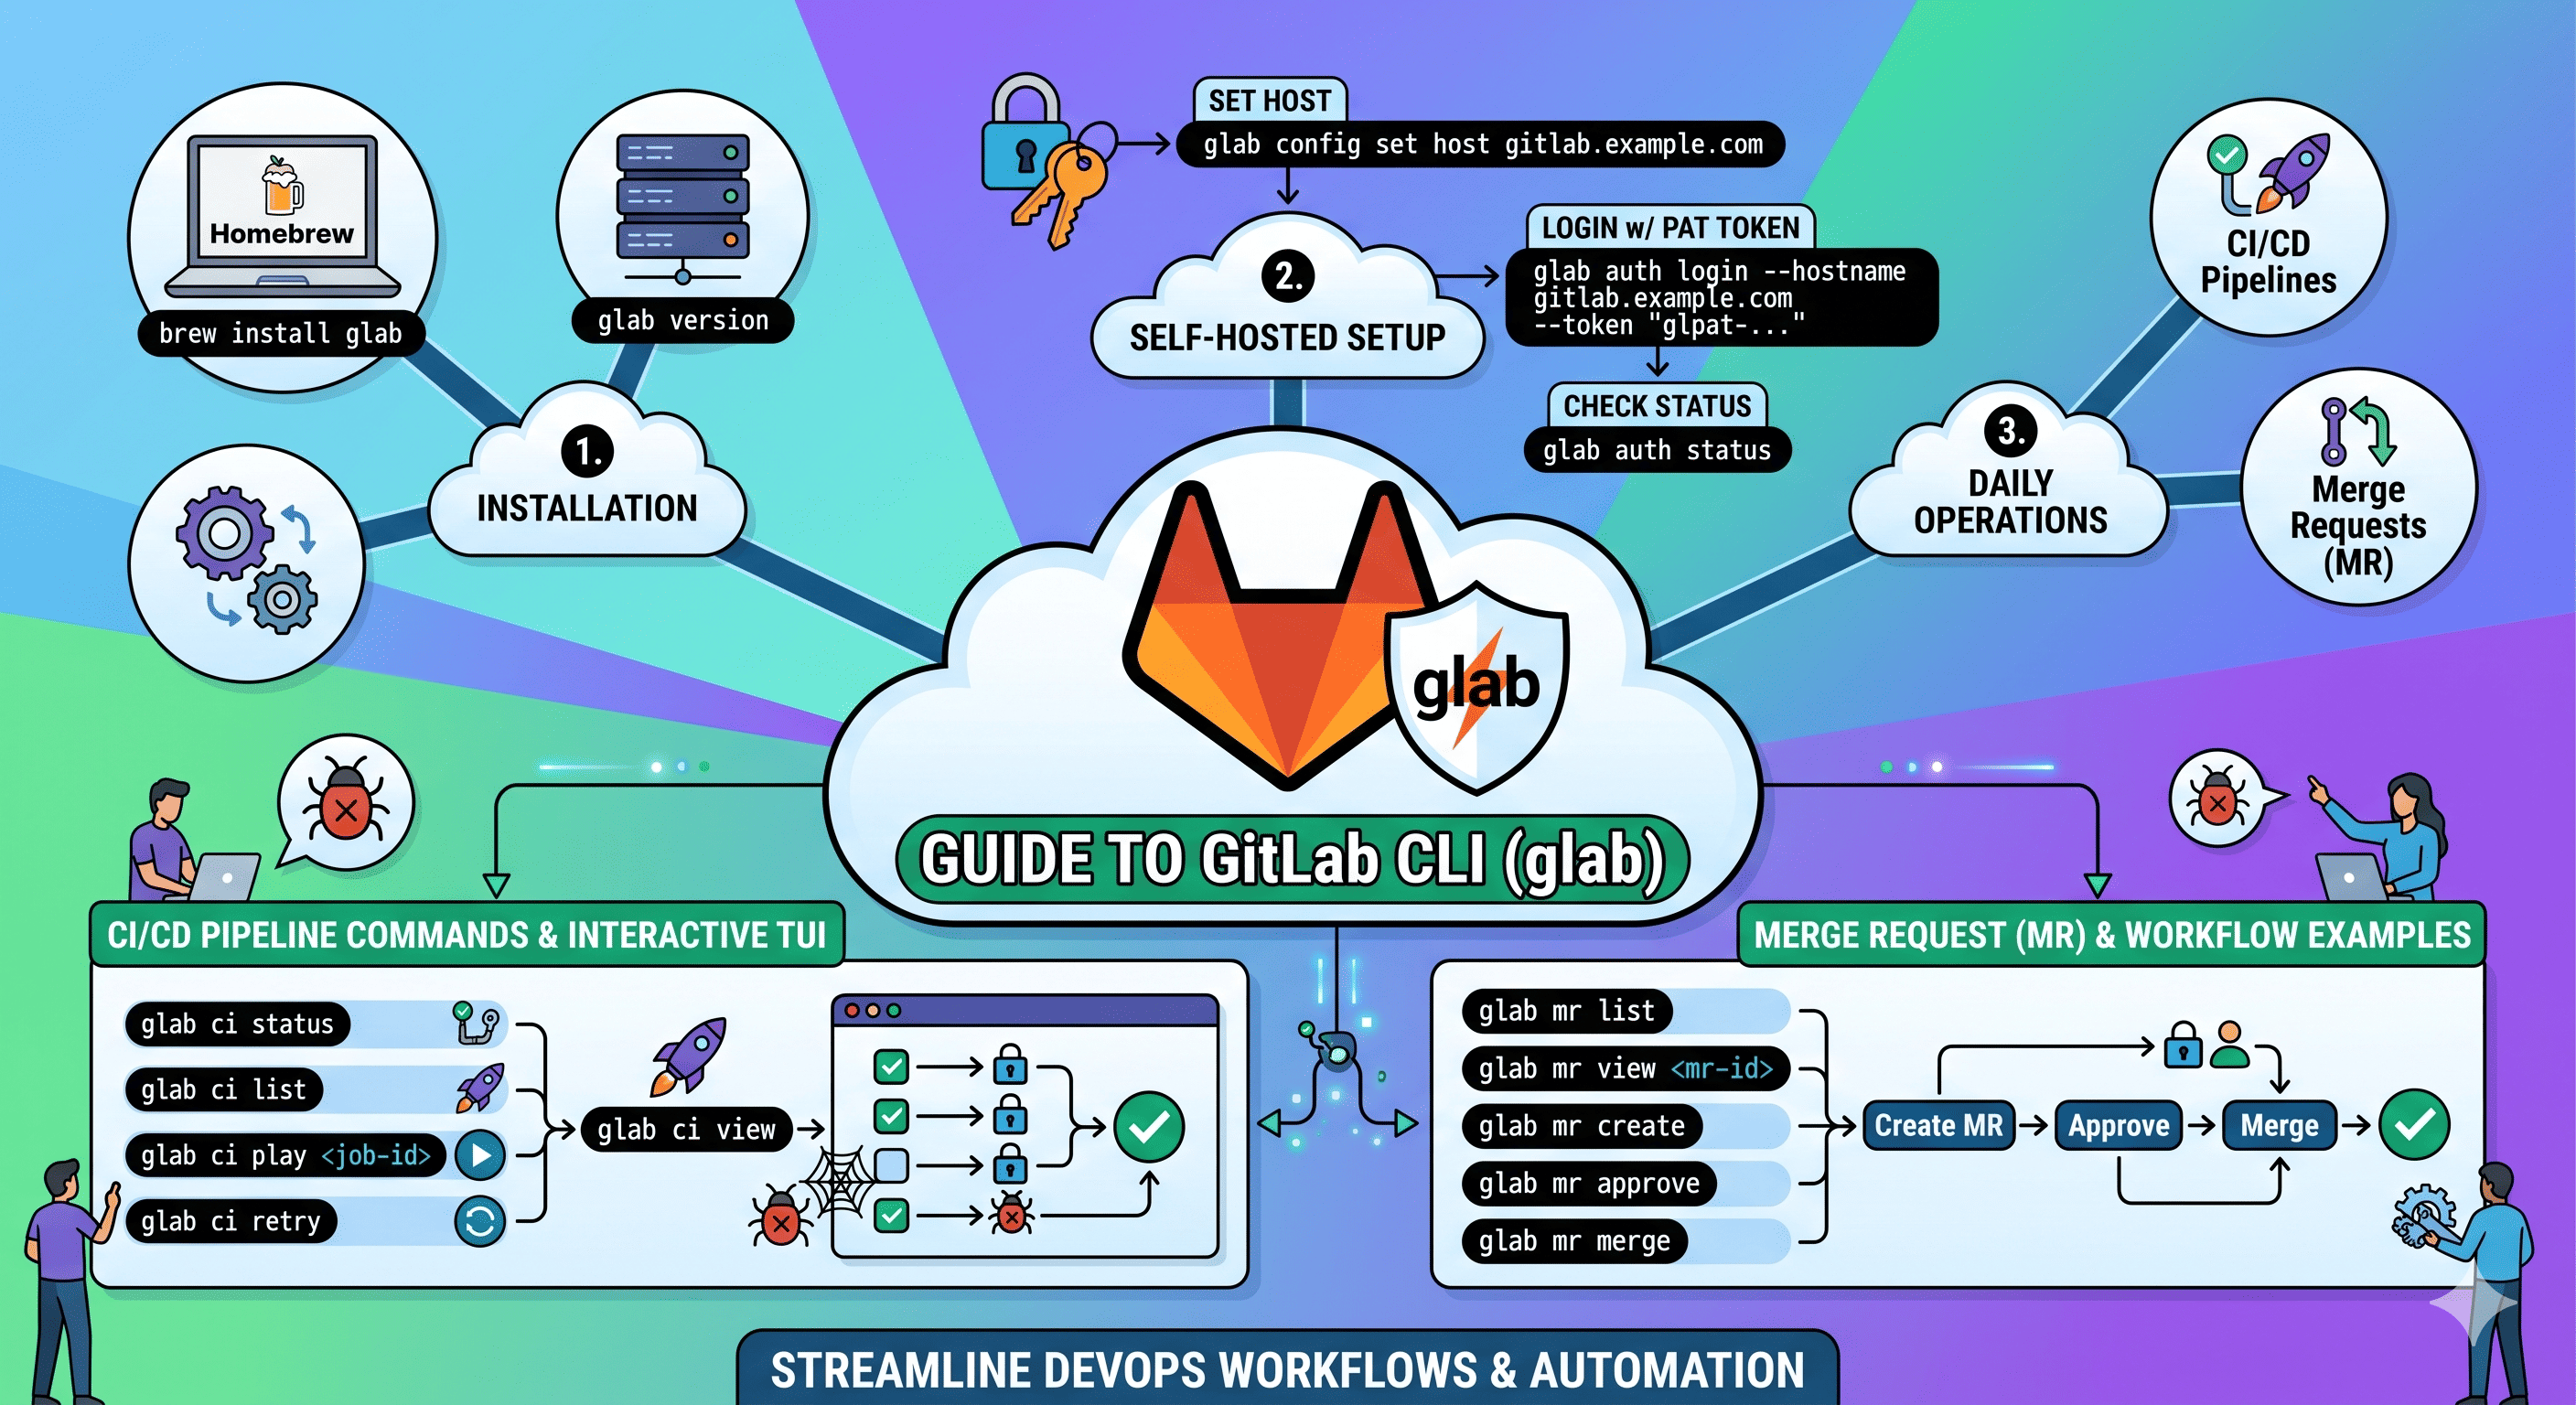
GitLab CLI(glab)로 터미널에서 GitLab 다루기

Overview평소 GitLab을 사용하다 보면 파이프라인 상태 확인, 실패한 잡 재시도, MR 리뷰 등을 위해 매번 웹 UI로 들어가야 하는 번거로움이 있다. GitHub의 gh CLI처럼 GitLab도 공식 CLI인 glab 을 제공하는데, 이를 활용하면 터미널을 벗어나지 않고 대부분의 작업을 처리할 수 있다. 특히 사내 Self-Hosted GitLab 환경에서 Kubernetes 인프라 레포지토리를 운영하다 보면 CI 파이프라인 모니터링과 manual job 트리거를 자주 하게 되는데, 매번 브라우저를 열기보다 터미널에서 한 줄로 처리하는 게 훨씬 효율적이다. 이번 글에서는 glab 설치, Self-Hosted GitLab 인증, 그리고 실제 자주 쓰는 명령어들을 정리해두려 한다. 1. ..

IaC/CI CD Tool 2026.11.12

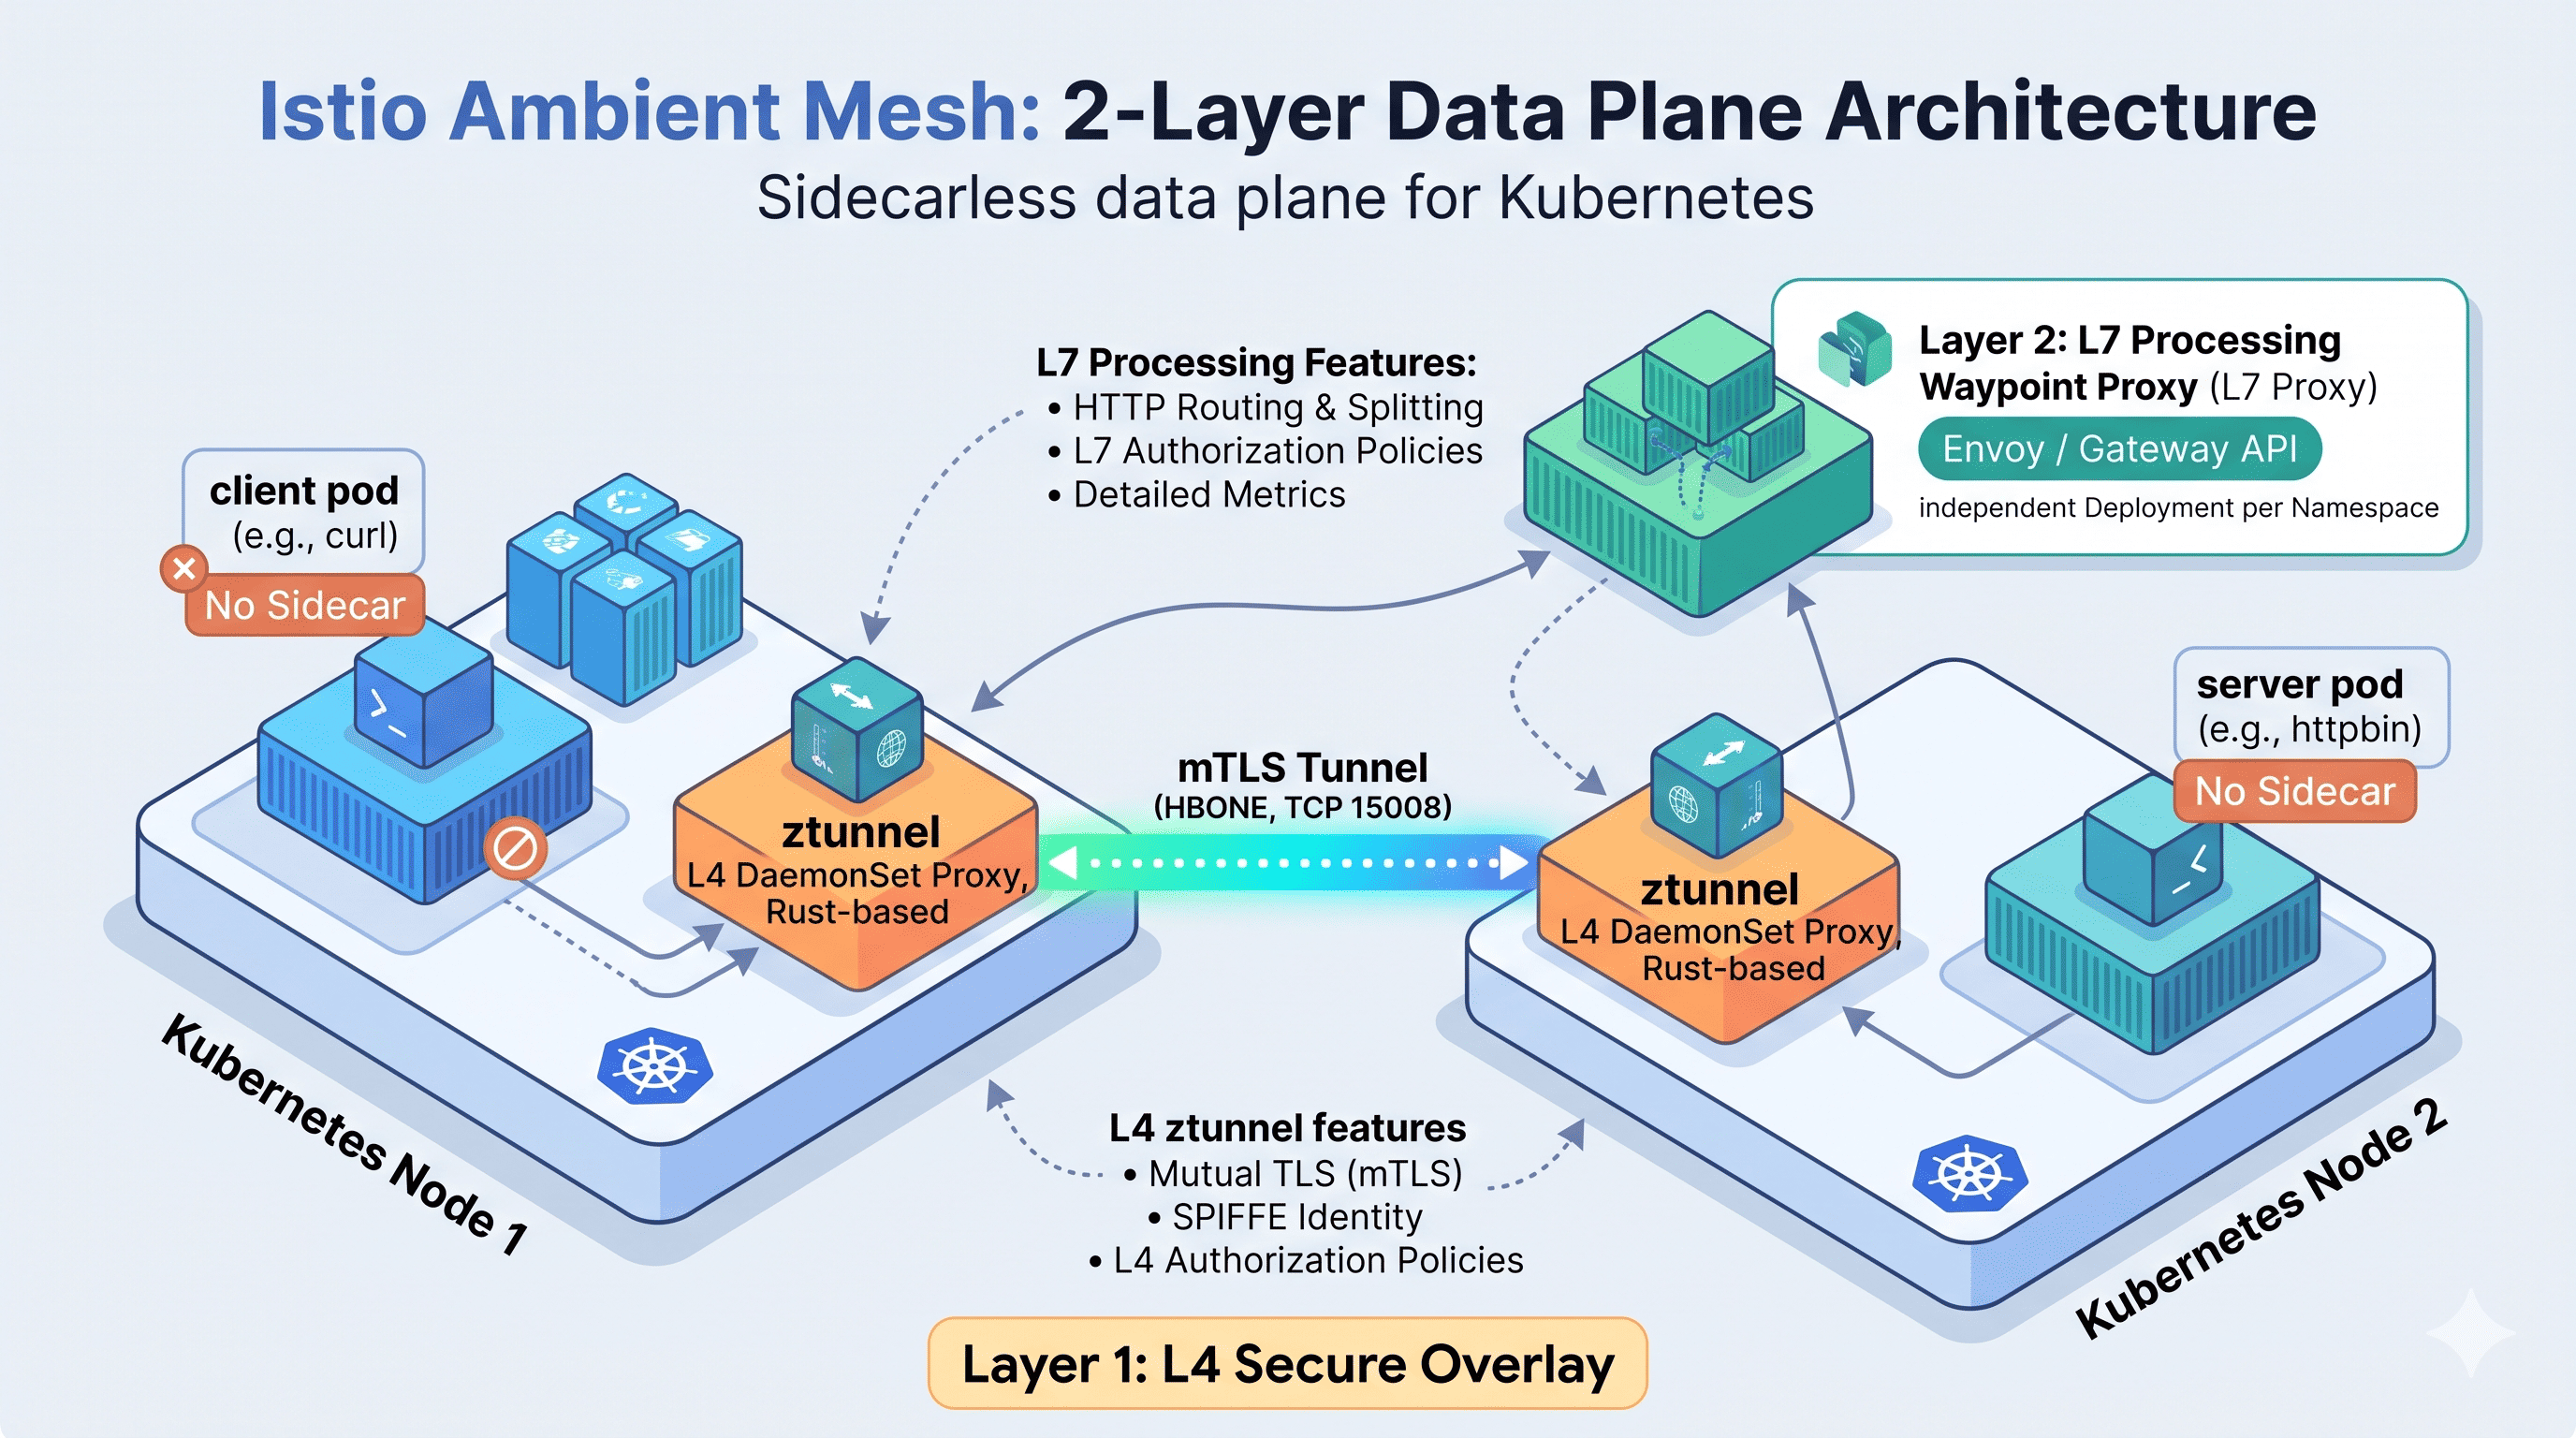
Istio Ambient Mesh: 사이드카 없는 서비스 메시

Overview쿠버네티스 환경에서 마이크로서비스 간 보안 통신(mTLS), 트래픽 라우팅, 관측성을 제공하는 사실상의 표준(de-facto standard) 솔루션으로 Istio가 널리 사용되어 왔다. 하지만 기존 Istio는 모든 애플리케이션 파드마다 Envoy 프록시를 보조 컨테이너로 삽입하는 사이드카(Sidecar) 아키텍처를 고수해 왔다. 이 방식은 대규모 클러스터에서 극심한 메모리 및 CPU 오버헤드를 유발하고, 프록시 설정이나 버전 업그레이드 시마다 대상 애플리케이션 파드를 강제로 재시작해야 하는 무거운 운영 부담을 안겨주었다. 이러한 사이드카 패턴의 구조적 한계를 근본적으로 해결하기 위해 정식 프로덕션 지원(GA) 단계에 도달한 혁신적 아키텍처가 바로 Istio Ambient Mesh이다. ..

IaC/Service Mesh 2026.11.12

단일 장애점과 영향 범위: 이중화해도 함께 멈추는 구성과 격리 경계 설계

Overview서버를 두 대로 늘리면 단일 장애점(SPOF)이 해결되었다고 생각하기 쉽다. 하지만 두 서버가 동일한 데이터베이스와 설정을 공유하고 같은 배포를 받는다면, 장애가 발생했을 때 두 대는 한 묶음으로 동시에 멈춘다. 단순히 서버 대수를 늘린다고 해서 공통 원인으로 인한 동시 장애 위험까지 사라지지는 않는다. 이 글에서는 이중화(Redundancy)의 규모를 단순한 서버 대수가 아니라 '공통 실패 단위(Unit of Failure)'를 기준으로 산정하는 법을 정리하고, 자원을 여분으로 두는 이중화와 장애 확산을 가두는 격리 경계(Blast Radius 제한)의 차이를 짚어본다. 나아가 결함이 있는 배포가 어떻게 격리 경계를 뚫고 전체 장애로 번지는지 분석한 뒤, 실제 사내 포털 무상태화 작업과 ..

CS 지식 2026.11.11
반응형